LocalAIで動かす社内ツールが、メモリ不足や推論先の障害で止まったら、別のモデルへ自動で切り替えられるのでしょうか。4.11.0では、一つのモデル名に代替推論先を順序付きで設定できます。ただし、切替が働くのは応答を確定する前の対象障害に限られます。さらに、入力を外部へ渡さない運用なら、代替先もその条件に合う構成にする必要があります。
今回の変更は、LocalAIで推論を運用する開発者にとって、障害への備えをモデル設定に組み込める点に意味があります。選ぶ軸は「代替先があるか」だけでなく、いつ切り替えられ、どこで処理が続くかです。

一つのモデル名の裏に、順番付きの代替先を置ける
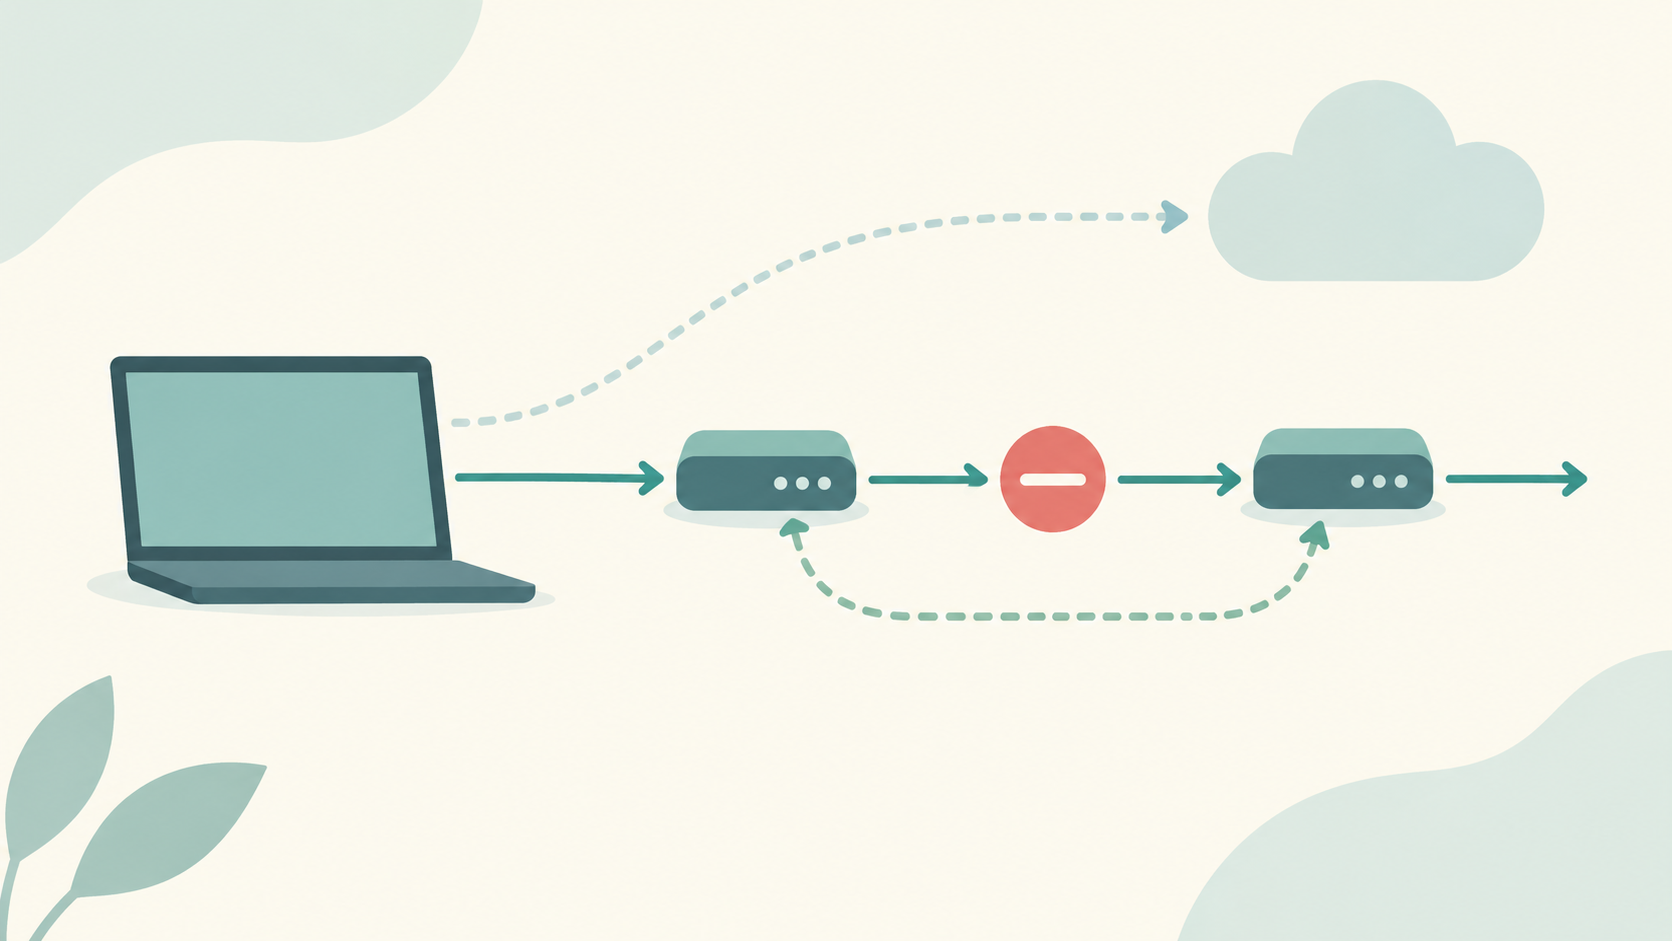
LocalAI 4.11.0の公式リリース説明では、モデル設定のfailover.targetsに、ローカルまたはリモートのモデルを順序付きで指定できます。先の推論先で対象の障害が起きると、次の推論先を試す仕組みです。
たとえば、通常使うローカルモデルを先頭に置き、別のローカルモデルを代替先にする構成が考えられます。利用するアプリには一つのモデル名を示しながら、その背後で切替先を管理できるため、推論先の選択をLocalAI側へまとめる使い方に向きます。
ただし、別モデルへ切り替わっても回答品質や出力形式が同じになるとは限りません。要約なら必要な情報が残るか、構造化出力ならアプリが受け取れる形になるかなど、代替モデルでも作業が成立することが採用条件です。この機能を回答品質の統一や処理の高速化まで保証するものとは扱えません。
救えるのは応答確定前の障害。出力途中の中断は別に考える
公式説明が切替対象に挙げるのは、通信エラー、サーバーエラー、メモリ不足、レート制限です。一方、検証エラー、通常のクライアントエラー、クライアントによるキャンセルは対象外です。根拠は「Model failover chains and localai-proxy」の説明にあります。
重要なのは、次の推論先を試す条件が応答確定前であることです。回答を返し始める前の対象障害には備えられますが、ストリーミングで文章を表示している途中の中断まで、代替モデルが続きを引き継ぐ保証ではありません。
そのため、回答が始まる前の失敗を減らしたい社内ツールには試す理由があります。一方、長い回答を最後まで途切れず届けることが必須のアプリでは、この切替機能だけで復旧設計を完結させられません。途中まで届いた応答をどう扱うか、再実行するかは、アプリ側にも残る判断です。
ローカル処理を維持するなら、代替経路も同じ条件にそろえる
切替先にリモートも指定できることは、使える計算資源を広げる特長です。しかし、入口が手元のLocalAIであっても、障害時の推論場所まで手元とは限りません。これはローカル・リモートを混在できる仕様から導ける運用上の違いです。
入力を外部へ送らないことが要件なら、代替先も許容するローカル環境に限定し、必要なモデルを動かせる容量と対応環境を用意する設計になります。主モデルがメモリ不足になったとき、代替モデルにも十分な資源がなければ、切替先を登録しただけでは備えになりません。
なお、リモートは必ずしも第三者クラウドを意味しません。別の社内LocalAIへ接続する構成もあり得ます。端末内だけで完結させたいのか、社内環境なら許容するのかを先に決めると、選べる代替先が明確になります。実際の送信先や認証、データ保持条件は接続先ごとに判断が必要です。
導入時は、切替先と応答を小さな構成で確かめる
公式Quickstartは、DockerでGPUを使う場合、NVIDIA CUDA、AMD ROCm、Intel GPU、Vulkanなど、ハードウェアに合ったイメージを選ぶよう案内しています。NVIDIAでは--gpus all、AMD・Intel・Vulkanでは対応する--device指定が必要です。モデル切替の設定と、各推論先を実行できる環境の準備は別の作業になります。
運用確認には、ヘルス状態や切替先を表示する機能、管理者による推論先の固定・解除も用意されています。応答ヘッダーのX-LocalAI-Served-ModelとX-LocalAI-Failoverも、どのモデルが処理したかを追う手掛かりです。出典:4.11.0の運用機能。
採用前の小規模な検証では、対象障害で予定した先へ切り替わるか、その先でもアプリに必要な応答を返せるかを組にして評価すると、設定の存在と実用性を分けて判断できます。本記事では実行試験を行っておらず、稼働率、待ち時間、モデル間の品質差、すべてのAPIでの切替互換性は評価していません。
情報は2026年10月10日(日本時間)確認の公式資料に基づきます。4.11.0の公開は日本時間10月3日6時56分です。
応答開始前の障害に備えたい既存LocalAI利用者で、代替モデルでも作業が成立するなら、試す理由があります。外部送信を避ける用途では、許容する処理場所から切替先を絞ってください。応答途中の完全復旧や同一品質が必須なら、その条件を満たす仕組みを別に評価できるまで、この機能だけを根拠に導入を決めるのは早いでしょう。
コメント