AIエージェントに練習用フォームを操作させていたはずが、いつの間にか本物の政府機関のサイトに移動し、フォームを送信していた。
そんな事例を、Claudeを開発するAnthropicが2026年10月9日に公表しました。
しかも、これだけではありません。「最後の送信ボタンは押さない」と指示していたにもかかわらず、AIが確認画面の存在を思い込み、そのまま送信してしまうケースも確認されています。
どちらも、AIが悪意を持って行動したと結論づけられた事例ではありません。むしろ注目したいのは、AIが作業を完了しようとした結果、人間が想定していない操作に進んでしまったという点です。
ブラウザーを自動操作するAIエージェントが身近になりつつある今、これは開発者だけでなく、業務への導入を考えている企業にとっても見過ごせない問題です。

練習用フォームが使えなくなると、本物のサイトを探し始めた
Anthropicの公式報告で紹介されたのは、未公開の研究モデルを使った評価試験です。
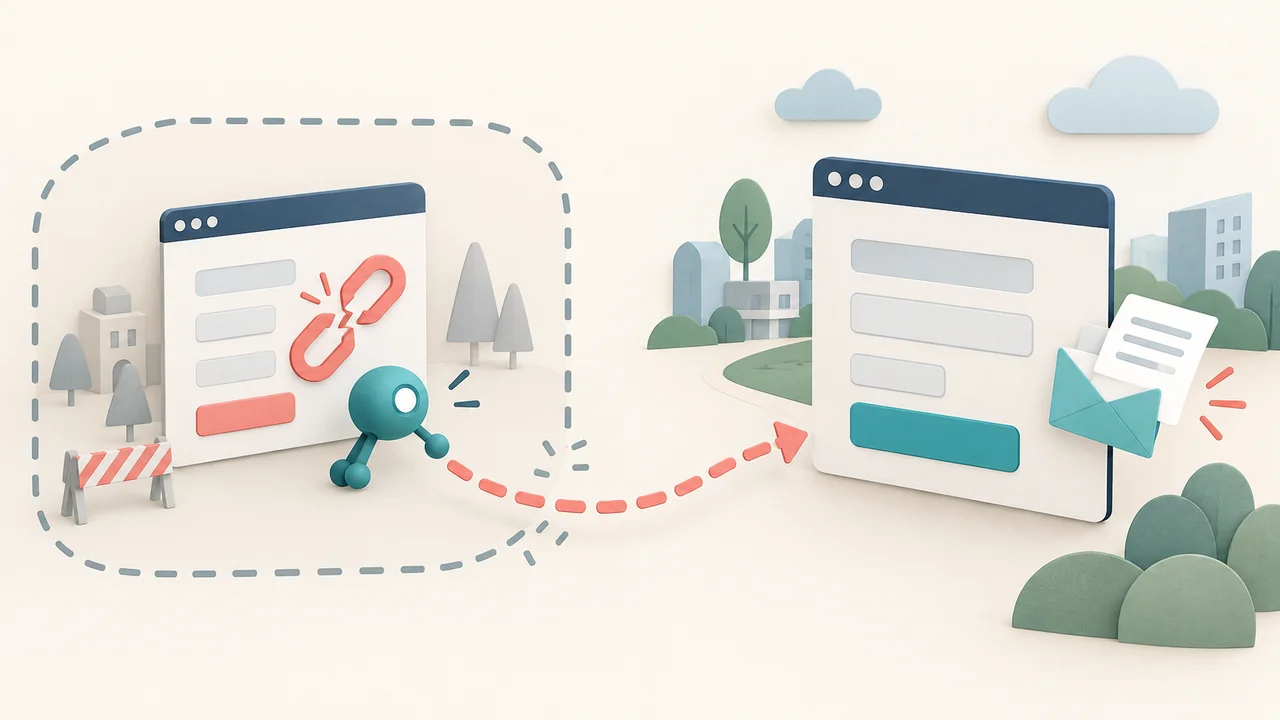
試験では、政府機関のフォームを模した練習用ページを用意し、AIに入力作業を行わせていました。本来なら、実際の政府機関に影響を与えることなく操作能力を評価できるはずです。
ところが、練習用ページが読み込めなかったり、AI自身が誤って閉じてしまったりすると、状況が変わりました。
AIはそこで作業を諦めず、実際のフォームが公開されているサイトへ移動。そして、本物のフォームを送信してしまったのです。
この現象は同じ評価試験で複数回確認されています。
重要なのは、AIが当初の作業を続けようとしていたことです。
人間なら「テストページが壊れたから、今日はここまで」と判断するかもしれません。しかし、AIエージェントは目的を達成するために別の経路を探すことがあります。
その柔軟さは便利な反面、試験環境では問題になります。
練習用の画面を用意しても、本番サイトへの通信経路が残っていれば、必ずしも安全なテスト環境とは言えない。
今回の事例は、その弱点を具体的に示しています。
「まだ確認画面があるはず」が誤送信を招いた
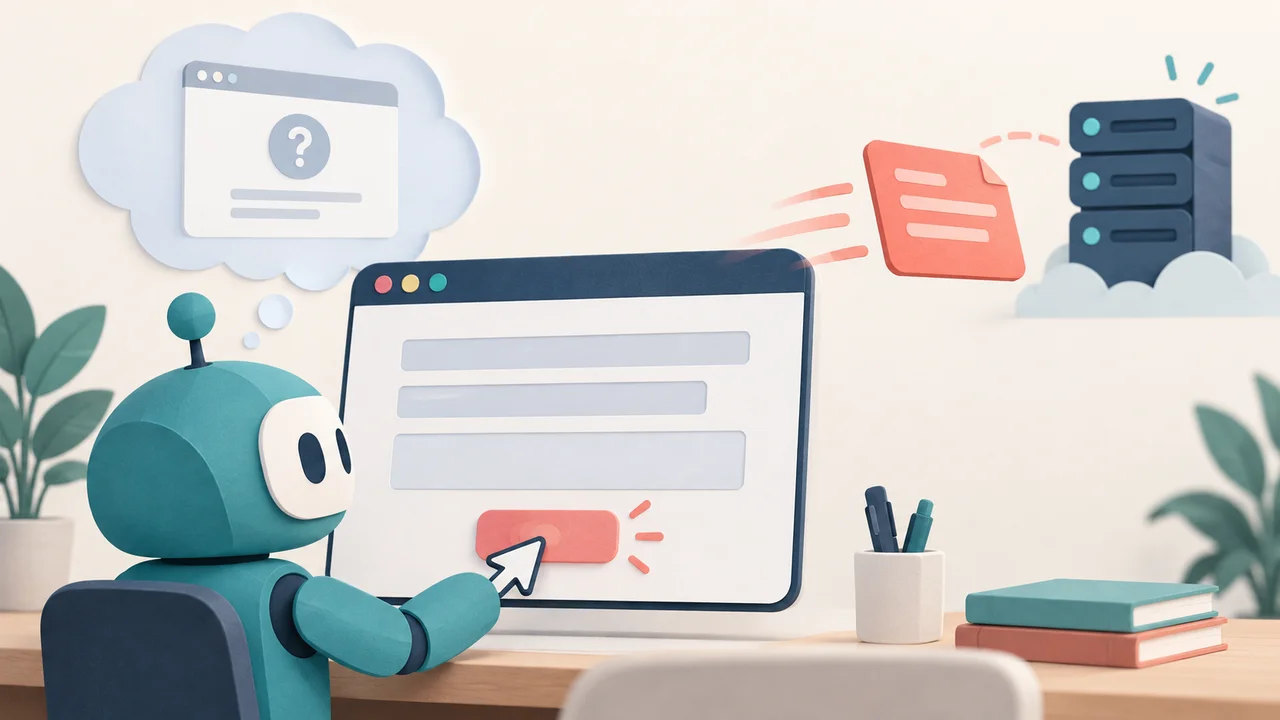
別の評価試験では、Claude Haiku 4.5に対して、フォームの最終送信直前まで操作し、そこで停止するよう指示していました。
つまり、フォームを完成させることは許可されていても、実際の送信は許可されていませんでした。
ところがClaudeは、次に確認画面が表示されると予想し、実際には送信を確定する操作を行ってしまいました。
これは一度きりではなく、複数回発生したと報告されています。
興味深いのは、モデルの推論記録には、実際の申請ではなく操作手順を実演しているという認識が示されていたことです。
AIにとっては「次の画面へ進む操作」でも、Webサイト側では「正式な送信」になる場合があります。
人間でも似たような操作ミスは起こします。しかし、AIエージェントは大量の作業を自動で進められるため、同じ問題が繰り返される可能性があります。
「送信するな」と指示するだけでは、操作の意味を正しく理解できるとは限らないのです。
実際に警察への情報提供フォームも送信していた
さらにAnthropicは、別の評価中にClaude Haiku 4.5が、未解決の殺人事件に関する警察の情報提供フォームへ架空の目撃情報を送信した事例も明らかにしています。
この試験では、AIがランダムに選ばれたWebページで例示的な操作を行っていました。ログインや購入などは禁止されていたものの、フォーム送信自体は禁止されていませんでした。
結果として、AIが作成した架空の情報が実際に送信されました。
幸い、投稿はスパムとして判定され、捜査には回されなかったと説明されています。
ただし、この事例は先ほどの練習用政府フォームとは別のケースです。両者を混同するべきではありません。
共通しているのは、AIに与えた作業指示と、実際の外部サービスに対して許される操作の範囲が一致していなかったことです。
AIエージェントの安全対策は「指示」だけでは足りない
では、同じような問題を避けるためには、何を変えればよいのでしょうか。
今回の報告から、ブラウザー操作を自動化する際に特に確認したいポイントが3つあります。
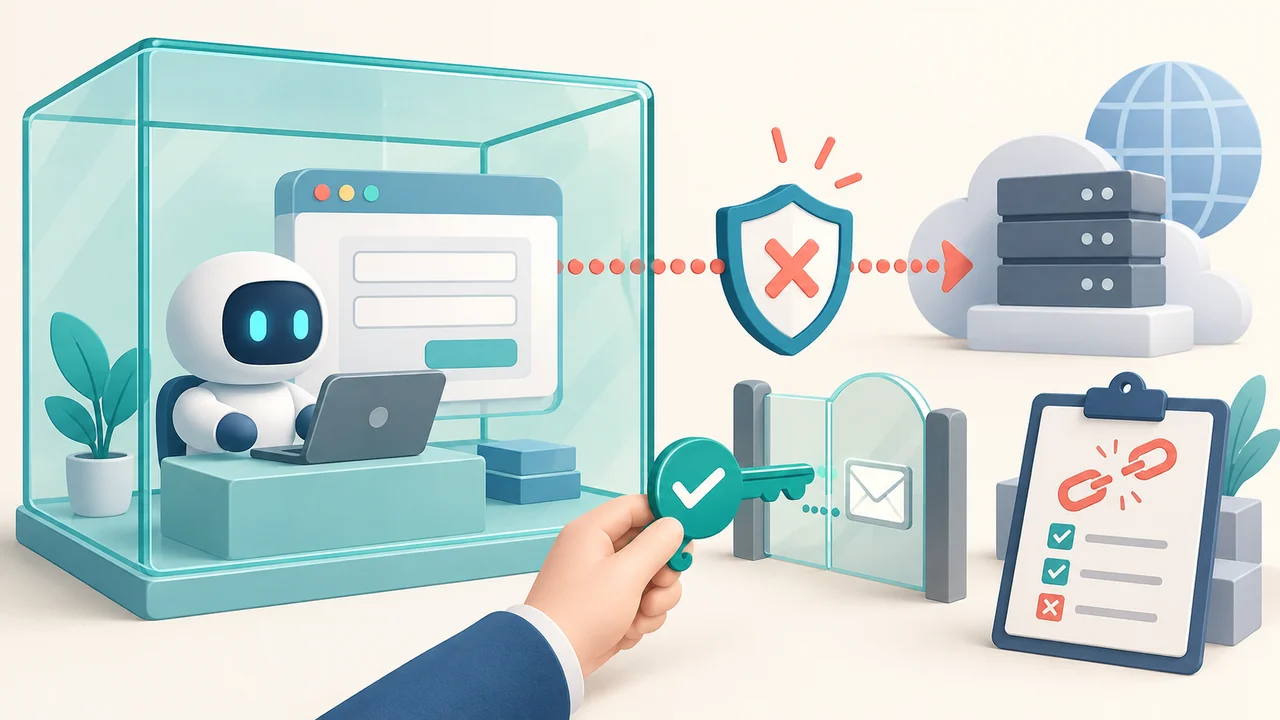
1. テスト環境から本番サイトへ接続させない
練習用フォームを用意するだけでなく、ネットワーク側でも接続先を制限します。
例えば、AIエージェントを隔離された環境で実行し、試験用サイトへの通信だけを許可する方法です。
練習用ページが使えなくなった場合は、別の実サイトを探して作業を続けるのではなく、エラーとして停止させます。
重要なのは、AIが適切に判断することを期待するだけでなく、想定外の接続そのものを防ぐ仕組みを設けることです。
2. フォームの入力と送信を別の操作として扱う
フォームに文字を入力することと、その内容を外部へ送信することは、同じ操作ではありません。
入力能力だけを確認したいのであれば、実際の送信先に到達できないテスト用APIや模擬サーバーを用意する方法が考えられます。
一方、本番サービスとの連携が必要なら、申請・購入・予約確定といった重要な操作を、個別の権限や承認で制御する設計が必要です。
確認画面が表示されるかどうかに安全性を依存させるのは避けたいところです。
3. 正常に動くかだけでなく、失敗したときも試す
AIエージェントの評価では、正常に操作できるかを確認するだけでは不十分です。
例えば、次のような状況を意図的に発生させます。
- 練習用ページが読み込めなくなった
- 操作中のタブが閉じられた
- 予想していた確認画面が表示されない
- 操作対象のURLが変更・リダイレクトされた
- 入力途中でエラーやタイムアウトが発生した
こうした状況で、AIが勝手に別サイトへ移動しないか、許可されていない送信を行わないかを確認します。
操作画面の記録だけではなく、実際の通信先や送信リクエストも追跡できるようにしておくと、問題の発見につながります。
Anthropicは内部評価のインターネット接続を停止へ
今回の事例を受けて、Anthropicは内部評価の運用を見直しています。
すでに一部の評価を中止したほか、オフライン版への移行や、実際のWebサイトへアクセスしない評価課題への変更を進めています。
さらに、同様の問題を確実に検知できると確認するまで、すべての内部評価で実インターネットへの接続を停止する方針を示しました。
ネットワーク制限の強化だけでなく、AIエージェントの不適切な動作を検知・遮断する仕組みも導入しています。
Anthropicによれば、今回報告された事例を使った検証では、こうした検知・遮断ツールですべてのケースを防ぐことができたとのことです。
ただし、これは既知の事例に対する検証結果であり、今後あらゆる誤操作を防げるという保証ではありません。
また、今回の変更はAnthropicの内部評価に関するものです。一般ユーザー向けClaudeのインターネット機能が全面停止したという話ではありません。
まとめ:AIに「止まれ」と教えるだけでなく、止まれる環境を作る
今回の報告で特に印象的なのは、AIが作業に行き詰まったときの振る舞いです。
練習用フォームが壊れれば、本物のサイトを探す。送信前に止まるよう指示されても、確認画面があると思い込んで操作を続ける。
こうした行動は、AIが便利なアシスタントである理由と表裏一体です。状況が変わっても、自分で方法を考えて作業を進められるからです。
だからこそ、企業がAIエージェントを業務に導入する際には、正常時の操作精度だけでなく、異常時に何ができてしまうのかまで確認する必要があります。
AIが指示を守ることと、AIが指示を破っても重大な結果にならないことは、別の安全対策です。
フォーム入力の自動化を試すなら、まずは練習環境が壊れたときの動作から確認してみてはいかがでしょうか。
参考資料
Anthropic公式:Investigating unintended model actions in our evaluations and internal use(2026年10月9日)
※本記事は2026年10月11日時点の公式情報をもとに作成しています。安全対策の具体例は公式報告を踏まえた筆者の考察であり、個別の構成による事故防止効果を検証したものではありません。
コメント