「Strataは速いらしい。でも、使い慣れたllama.cppから乗り換えるほどなん?」
ローカルLLMを触っていると、こういう話は気になりますよね。
どうも、ベア三郎です。
今回はNVIDIA DGX Sparkに、約94GBのQwen3.8-Flash-Next(UD-IQ4_XS)を載せて、推論エンジンのStrataとllama.cppを実機で比較しました。
やってみて面白かったのは、「1人で文章を生成する速さ」と「何人かで使ったときの快適さ」は、まったく同じではなかったこと。資料を読ませたときはStrataが好成績。一方、4件・8件の質問を同時に投げると、今回の構成ではllama.cppが大きくリードしました。
数字の競争だけでなく、「チャットで待たされないのは?」「社内で共有するなら?」「128GBでメモリは足りる?」まで、実測結果から見ていきます。

先に結論。長文生成はStrata、短文チャットと同時利用はllama.cpp!
今回の条件では、普段のチャットや複数人での利用を優先するなら、llama.cppを最初の候補にしたいところです。最初の文字が表示されるまでの時間が短く、GGUFモデルを直接読み込めるので導入も比較的シンプルでした。
ただし、Strataが遅いという話ではありません。約5,200トークンの資料参照では、Strataが34.00TPS、llama.cppが24.07TPS。回答完了までの時間もStrataのほうが短い結果でした。
ポイントは、どちらが「最強」かではなく、どんな使い方で何を待たせたくないかです。
そもそもTPSが高ければ、チャットは快適?
ここで、ベンチマークによく出てくる数字を整理しておきましょう。
TPS(Tokens Per Second)は、AIが1秒間に生成するトークン数。トークンは文章を処理する単位で、日本語の文字数とは一致しません。仮に600トークンを生成するなら、20TPSで約30秒、30TPSで約20秒、40TPSで約15秒。長い回答ほど差が効いてきます。
でも、私たちがチャットで最初に感じるのは「回答が出始めるまでの間」です。これをTTFT(Time To First Token)といいます。
たとえ生成が速くても、最初の一文字まで数秒待たされれば「ちょっと遅いな」と感じるもの。逆に生成TPSが少し低くても、すぐ文字が流れ始めると軽快に感じます。
そして複数人で使うなら、サーバー全体でどれだけ処理できるかという総TPSも大事。今回はこの3つを混同しないように比較しています。
検証したのは、128GBのDGX Sparkと約94GBのIQ4モデル
今回使ったのは、NVIDIA GB10を搭載したDGX Spark 1台(128GBのCPU・GPU共有メモリ)です。GPU用128GBとCPU用128GBが別々にあるわけではありません。
モデルはUnslothのQwen3.8-Flash-Next UD-IQ4_XS。量子化によって重みの保存容量を抑えたGGUF版で、3分割のファイルを合わせて約93.68GBです。名前に「IQ4」とあっても、全ての部位を一律4ビットにしているわけではありません。元ファイルのSHA-256も照合して、両方で同じ配布モデルを使いました。
Qwen公式によると、言語モデル本体は125B(1,250億パラメータ)ですが、1トークンの処理で使うのは主に6B。これはMoE(必要な専門家だけを呼び出す仕組み)のおかげです。さらに51Bのn-gram embedding(トークンの並びを引く巨大な表)も備えています。ただし、毎回計算しない重みも保存する必要があります。「6Bしか使わないから、メモリも6B分で十分」というわけではないんです。
比較では、短い会話、約5,200トークンの架空資料の参照、Pythonコード生成を各3回測定。さらに、1・2・4・8件の一斉送信や、時間差での質問も試しました。どちらも4処理枠、各8,192トークン、Thinking無効、温度0を基本にしています。
ただし、ここは大切な注意点。StrataはDGX Spark用のArm64フォークを使い、単独推論時にMTP(次に出るトークンを先読みする仕組み)を有効化。llama.cppの主比較ではMTPを無効にしています。さらに、Strataでは一部の重みをBF16へ丸め、CPU/GPUへの配置やメモリ上限も異なります。今回は実際に使える設定同士を比べたもので、ソフトだけの純粋な優劣を証明する試験ではありません。
1人で使うと、資料参照とコード生成はStrataが健闘
まずは、1件ずつ質問した場合の測定です。
| テスト(入力→出力) | Strata:生成TPS/初動/完了 | llama.cpp:生成TPS/初動/完了 |
|---|---|---|
| 短文チャット(50→128) | 25.80/1.30秒/6.19秒 | 24.89/0.26秒/5.35秒 |
| 架空資料の参照(5,222→128) | 34.00/6.22秒/9.60秒 | 24.07/7.10秒/12.40秒 |
| Pythonコード生成(76→256) | 31.60/0.97秒/9.04秒 | 25.09/0.33秒/10.49秒 |
各3回の中央値。初動=TTFT、完了=質問送信から応答終了まで。生成TPSは各サーバーの計測値です。
注目したいのが短文チャット。生成速度だけならStrataが25.80TPS、llama.cppが24.89TPSでわずかに上回ります。しかし最初の文字が届くまでの時間はStrataが1.30秒、llama.cppはわずか0.26秒。会話全体もllama.cppのほうが早く終わりました。
一方、資料参照では逆の結果に。Strataは34.00TPSで、回答完了も9.60秒。llama.cppの12.40秒より約2.8秒早く終わっています。Pythonコード生成でもStrataが完了時間で上回りました。
もっとも、Strataの資料参照には初回TTFTが14.76秒という測定もあります。中央値だけ見て「毎回この速さ」と期待するのは禁物です。専門家キャッシュの温まり方など、揺らぎも残っています。
4件同時で様子が一変。llama.cppの総TPSは61.35
ここが今回、いちばん伝えたいところです。
1人で使うなら十分速くても、同じSparkをチームで共有したらどうなるのか。1・2・4・8件のリクエストを一斉に送り、それぞれ3ラウンド測定しました。
同じ128トークン出力を使った一斉送信。総TPSはラウンド全体の処理量、初動・完了は各リクエストの中央値です。数字が大きいほど良いのは総TPSだけ。
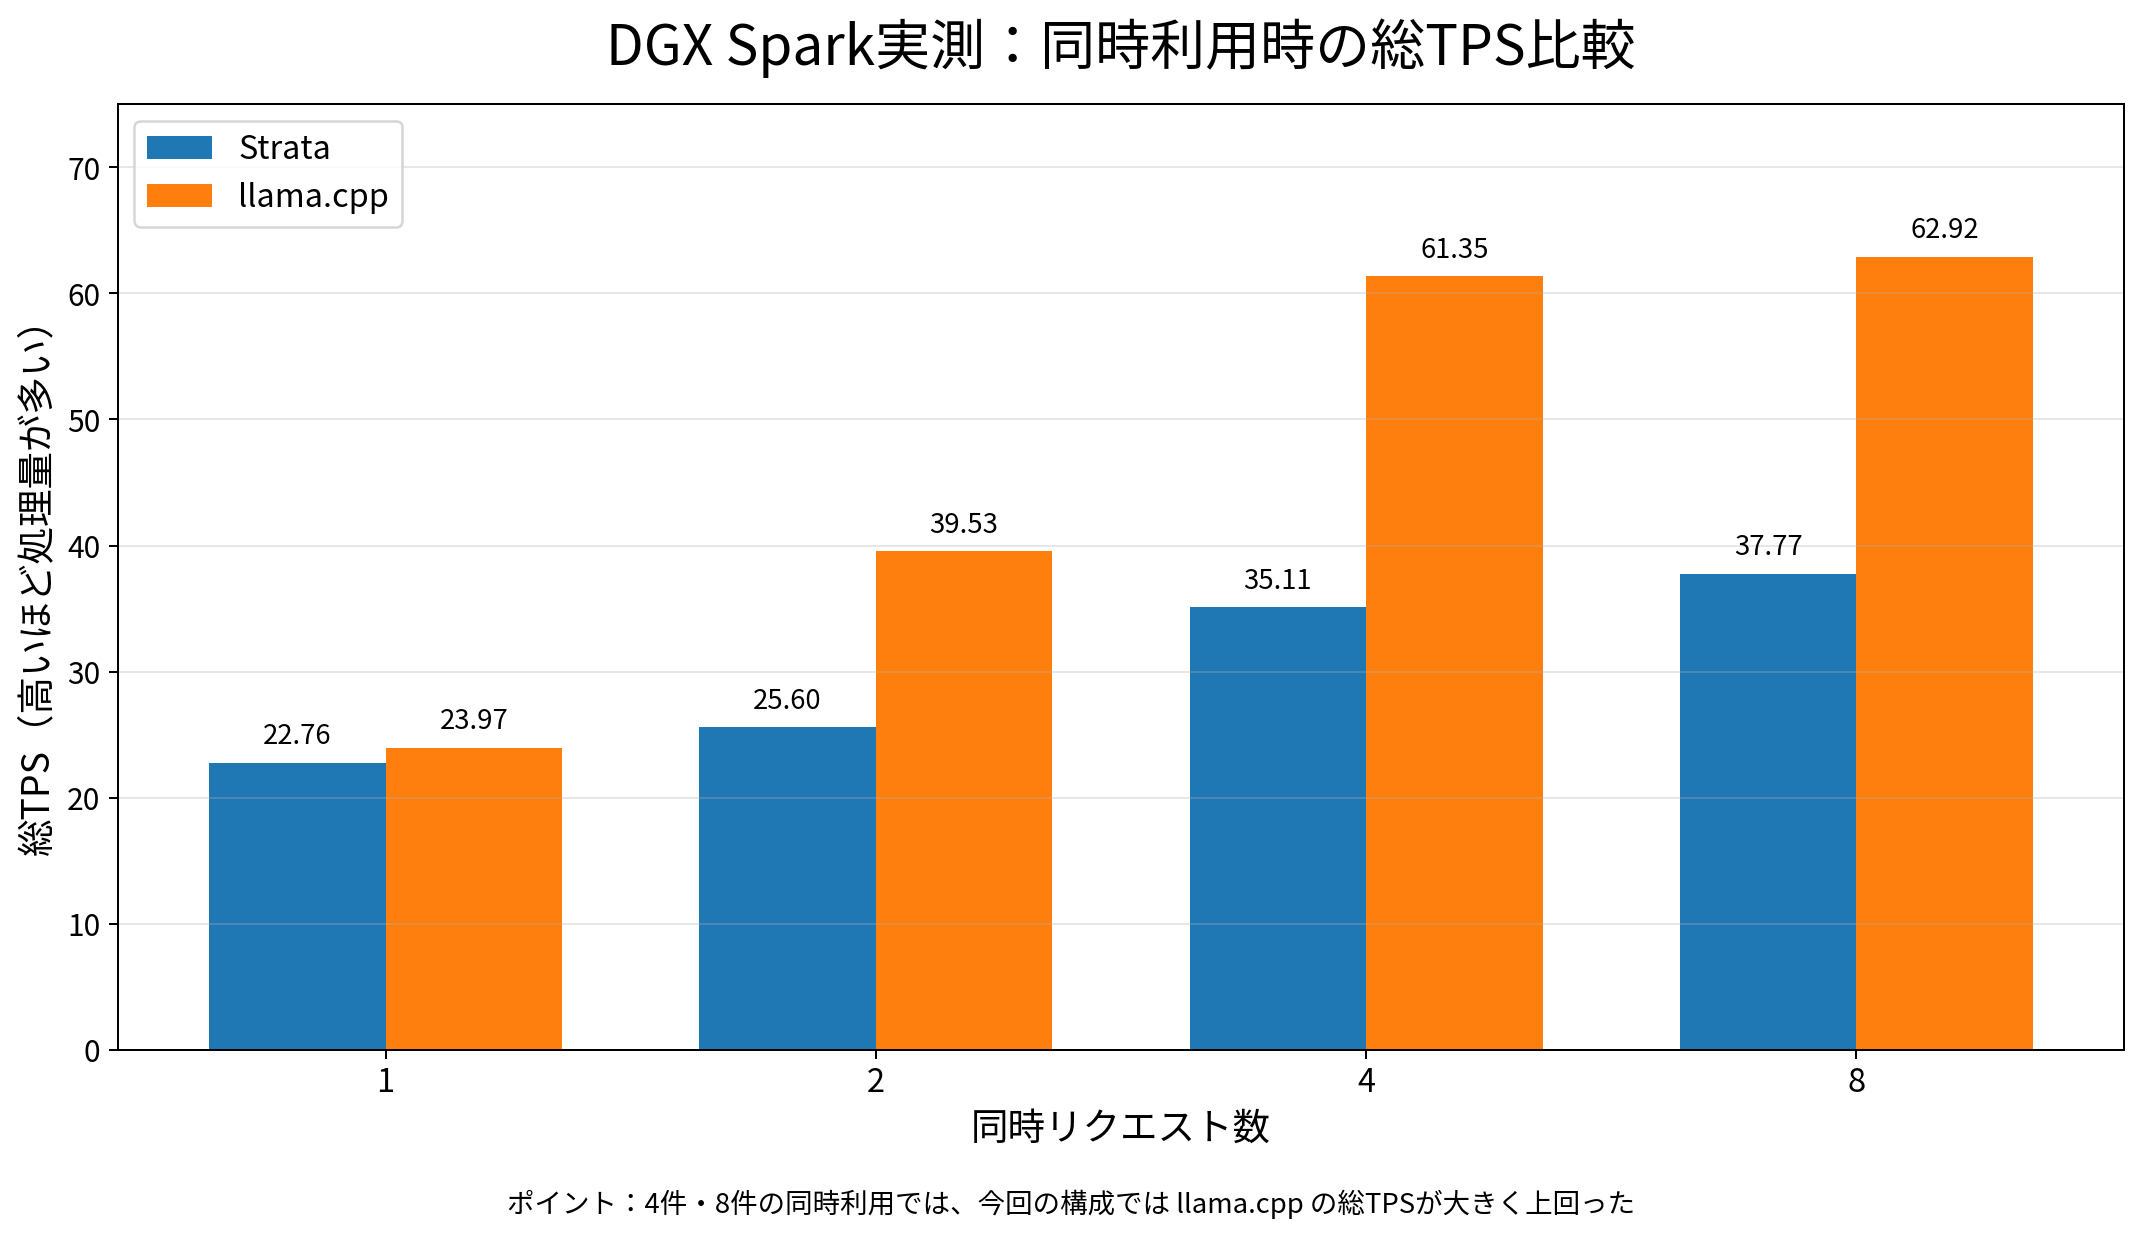
4件同時では、llama.cppが61.35TPS、Strataが35.11TPS。llama.cppの総処理量は約1.75倍でした。8件同時でもその差は続き、複数人で使う場面ではllama.cppが優勢という結果に。
4件同時では、Strataの総TPSが35.11に対して、llama.cppは61.35。 しかも最初の文字までの待ち時間は、Strataが3.51秒、llama.cppが0.81秒です。
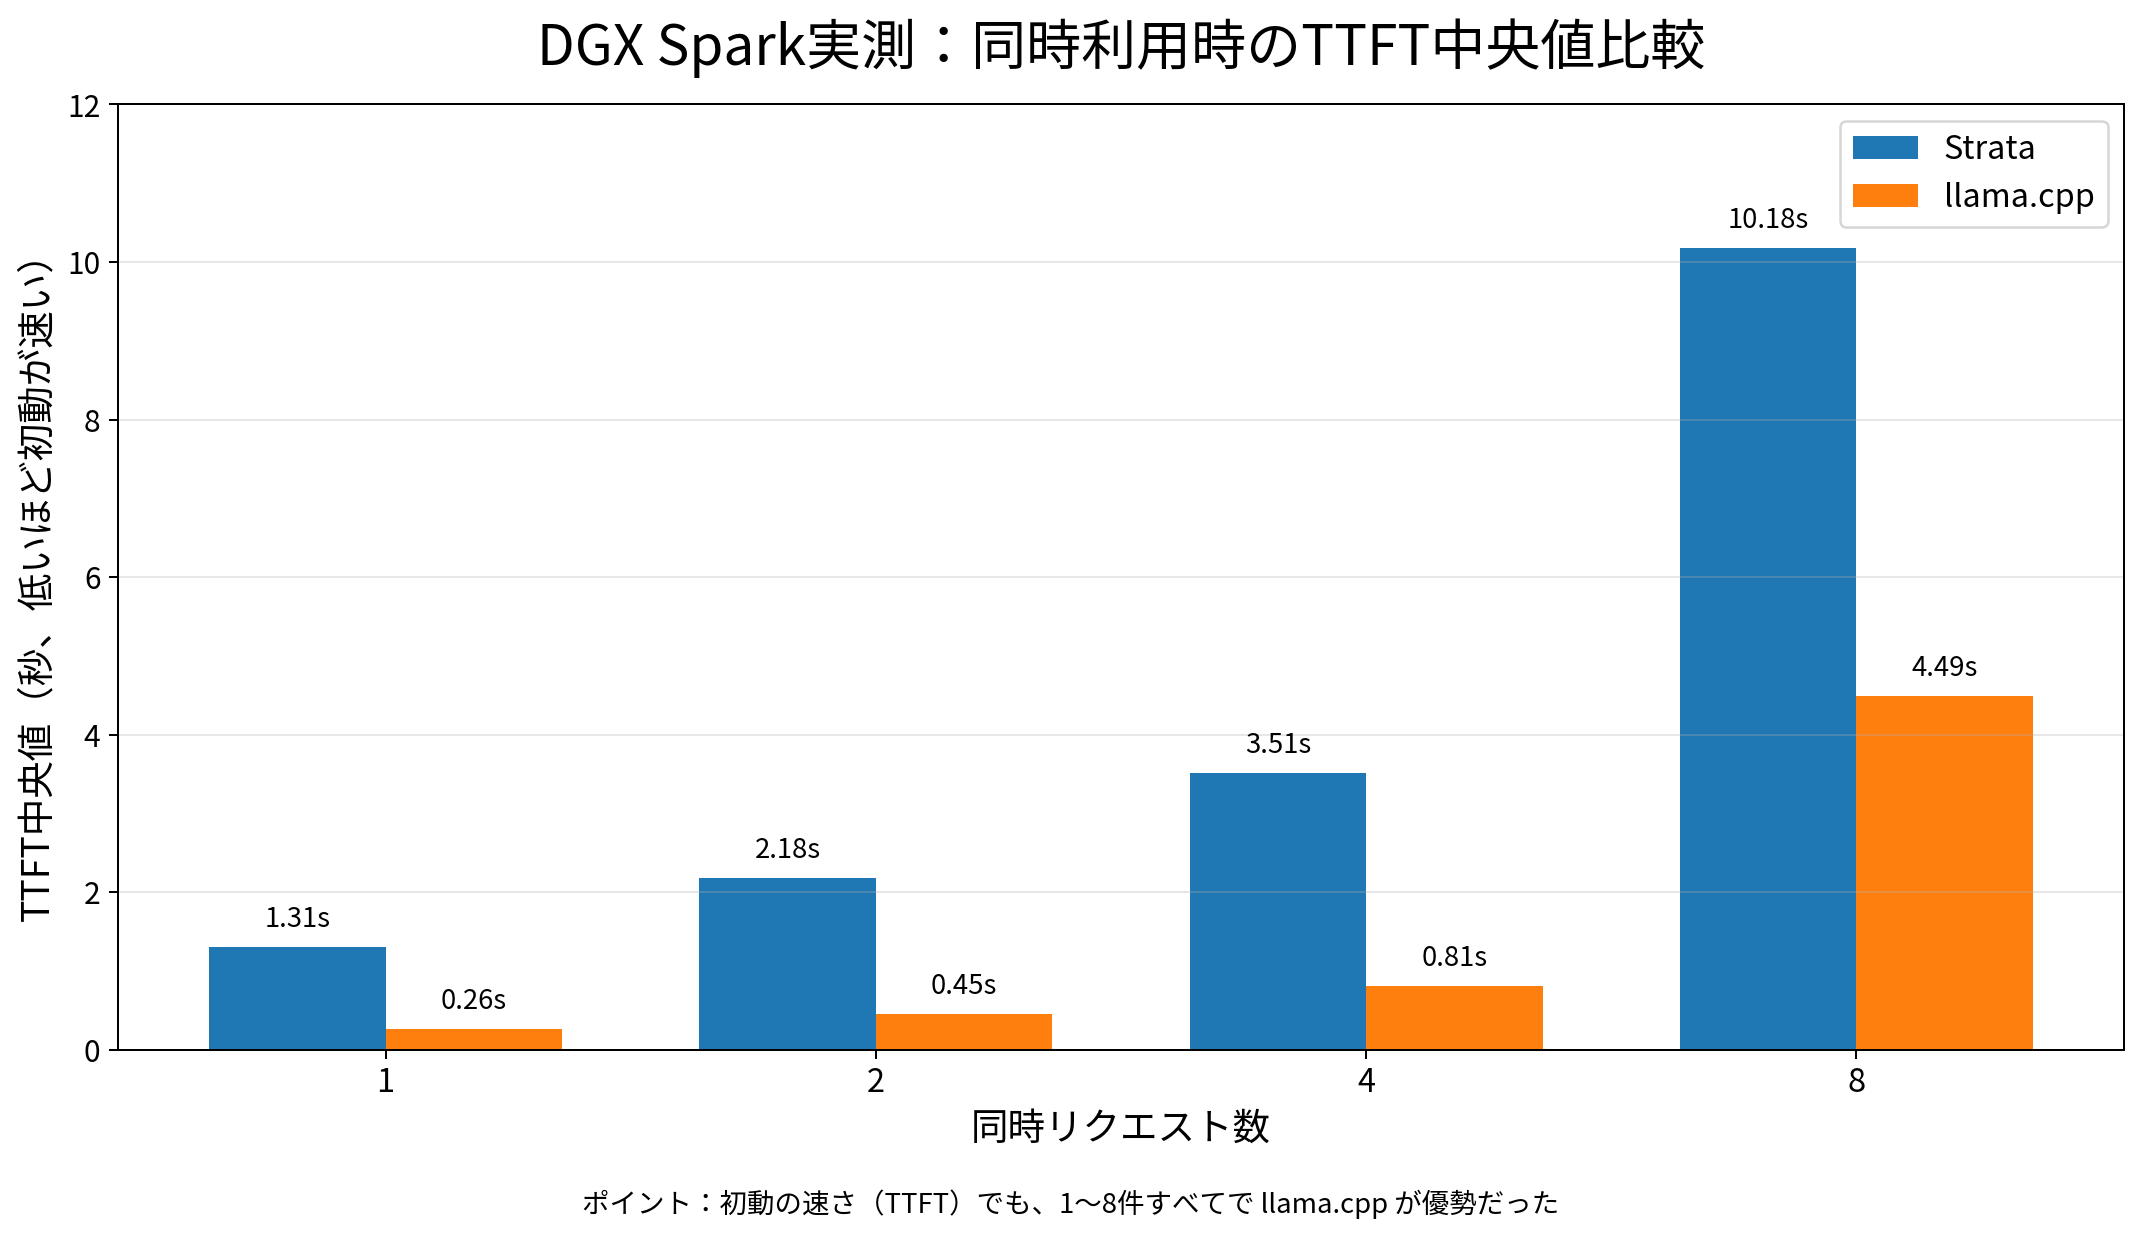
処理量だけでなく、待ち時間にも注目。8件同時の応答開始はStrataが10.18秒、llama.cppが4.49秒(中央値)。複数人でチャットするなら、最高TPSよりも「いつ回答が始まるか」が快適さを左右します。
| 同時リクエスト数 | 総TPS(Strata/llama.cpp) | 初動中央値(Strata/llama.cpp) | 完了中央値(Strata/llama.cpp) |
|---|---|---|---|
| 1件 | 22.76/23.97 | 1.31/0.26秒 | 5.62/5.34秒 |
| 2件 | 25.60/39.53 | 2.18/0.45秒 | 9.95/6.45秒 |
| 4件 | 35.11/61.35 | 3.51/0.81秒 | 14.51/8.30秒 |
| 8件 | 37.77/62.92 | 10.18/4.49秒 | 21.77/11.91秒 |
8件になると差はさらに体感に響きます。Strataの初動中央値は10.18秒、llama.cppは4.49秒。完了中央値も約22秒対約12秒。どちらも同時処理はできていますが、チャットの軽快さは大きく違いました。
ここで勘違いしたくないのは、総TPSが増えたからといって、一人ひとりの回答が速くなるわけではないこと。4件同時の利用者別生成速度は、Strataが11.70TPS、llama.cppが16.91TPS。1人で使うときより落ちています。
また、今回は4処理枠に対して8件を送信しています。枠を超えたリクエストには順番待ちが発生し得ます。ただしAPIからキュー開始時刻を取得できていないため、TTFTのすべてを「キュー待ち時間」とは呼べません。
長い資料を読ませると、短い質問まで待たされる
実際の利用では、全員が同時に「送信」ボタンを押すことはあまりありません。そこで質問を1秒ずつずらしたり、長文の直後に短い質問を投げたりもしました。
8件を1秒間隔で送信したとき、初動中央値はStrataが6.44秒、llama.cppが2.63秒。一斉送信とは違う結果です。
さらに、約5,200トークンの資料を送った1秒後に短文を送信したところ、後から来た短文の初動中央値はStrataが9.54秒、llama.cppが6.43秒になりました。
たとえば、Aさんが長い資料の要約を依頼している間に、Bさんが「この設定って何だっけ?」と一言だけ質問する場面。Bさんの質問は短くても、資料の読み込み処理と計算資源を共有するため、待たされることがあります。
社内向けローカルAIは、短文チャットだけで負荷試験を終わらせないほうがいい。 今回の測定で、これは強く感じたポイントです。
128GBもあるのに、メモリの余裕は意外と少ない
「モデルが約94GBなら、128GBとの差で30GB以上空くのでは?」と思いたくなります。でも、動作中はモデルの重み以外にも、KVキャッシュや作業領域、OS、ほかのアプリがメモリを使います。
今回のSparkでは既存のOpen WebUIやDifyなどを動かしたまま、Ollamaの別モデル(約36GBの常駐表示)も維持して測っています。専用の空っぽのマシンではありません。
| 動かし方 | 測定中のホスト空きメモリ最小 |
|---|---|
| Strata:RAM32GiB+GPU専門家キャッシュ | 24.26GiB |
| llama.cpp:MoEを全GPU配置 | 19.11GiB |
| llama.cpp:MoE先頭12層をCPU側に配置 | 32.55GiB |
llama.cppで一部をCPU側に移すと空きは増えますが、短文の生成速度は15.21TPSまで低下しました。全GPU配置では24.89TPSだったので、メモリの余裕と速さを交換している形です。
ただし、上の空き容量はホスト全体の値。両エンジンでコンテナのメモリ上限も異なるため、エンジン単体のVRAM使用量ランキングではありません。この数字をそのまま別のSparkへ当てはめないでください。
セットアップの手軽さはllama.cpp。Strataはまだ「試す楽しさ」がある
導入のハードルも、実際に触ると差がありました。
llama.cppはGGUFモデルを直接指定して起動。一方、今回のStrataはArm64対応フォークのビルド、専用形式への変換、MTP重みの取得・変換、ビルド時のリンク調整が必要でした。
しかも、先に試した別のIQ3量子化ファイルは、Strata側が埋め込み重みの形式に対応できず起動失敗。「IQ3なら小さくて動くはず」とは限らないんです。最終的に今回のUD-IQ4_XSでは両エンジンの動作を確認できました。
Strataは、重みをどこに置くかを工夫したり、MTPを試したりする面白さがあります。ただ、誰にでもすぐ勧められる簡単さという点では、今回の環境ではllama.cppに軍配が上がります。
なお、llama.cppにもMTPの実装は存在します。今回の主比較でMTPを無効にしたことと、「llama.cppはMTP非対応」という話は別です。
では、あなたのDGX Sparkにはどちらが合う?
1人でチャットやコード補助に使うなら、まずllama.cpp。 初動の軽さは素直に魅力です。GGUFのまま試せるので、設定で悩む時間も抑えられます。
長文処理の生成速度やMTPのチューニングに興味があるなら、Strataは面白い選択肢。 今回の資料参照では確かに好成績でした。ただし、入力の長さや重み配置、MTPの設定で結果は変わります。
Open WebUIなどを介して数人で共有するなら、今回の結果ではllama.cppを基準に検証を始めたいところです。ログインできる人数と、同時に推論しているリクエスト数は違います。想定人数でのTTFTと完了時間、長文が混ざったときの挙動を見て決めるのが近道でしょう。
最後に検証の範囲も明記しておきます。今回確認した実入力の最大は5,222トークンで、32K・128K・256Kの長文入力を埋めた性能は未測定。16件・20件同時、長時間連続稼働、実際のOpen WebUI画面からの操作も未検証です。資料中の事実参照と短いPython関数のチェックは通りましたが、回答は出力上限で切れており、総合的な日本語品質まで判定したものではありません。
まとめ:ベンチマークの「最高TPS」だけで選ぶと、もったいない
DGX Sparkに大きなモデルを載せられる。それだけでもワクワクする時代になりました。
でも、実際に使うときに大事なのは、最高速度の数字だけではありません。最初の文字がいつ出るか。最後まで何秒かかるか。隣で誰かが長い資料を読ませたとき、自分のチャットはどうなるか。
今回の実測では、単独の資料参照はStrataが好成績、4〜8件の同時処理はllama.cppが優勢でした。私なら、まずllama.cppで普段の使い方を測り、そこからStrataでどこまで伸ばせるか試してみます。
「モデルが動いた」の次は、「どう使えば気持ちよく動くか」。 Sparkの面白さは、むしろここからですね。
検証メモ: 2026年10月12日、DGX Spark(GB10)1台で実測。IQ4の試験リクエストは計297件がストリーム完了。記事のStrata対llama.cppの主比較は各96件(単独9件、一斉45件、時間差36件、長短混合6件)。ストリーム完了は回答全文の品質合格を意味しません。測定時のStrataはArm64フォーク52470278377b(実行時0.1.39)、llama.cppはa9d27ac693ff。比較値は各3回または3ラウンドの中央値です。
参考リンク: NVIDIA DGX Spark公式 / Qwen3.8-Flash-Next公式モデルカード / Unsloth GGUF / Strata本家 / DGX Spark向けStrataフォーク / llama.cpp
コメント