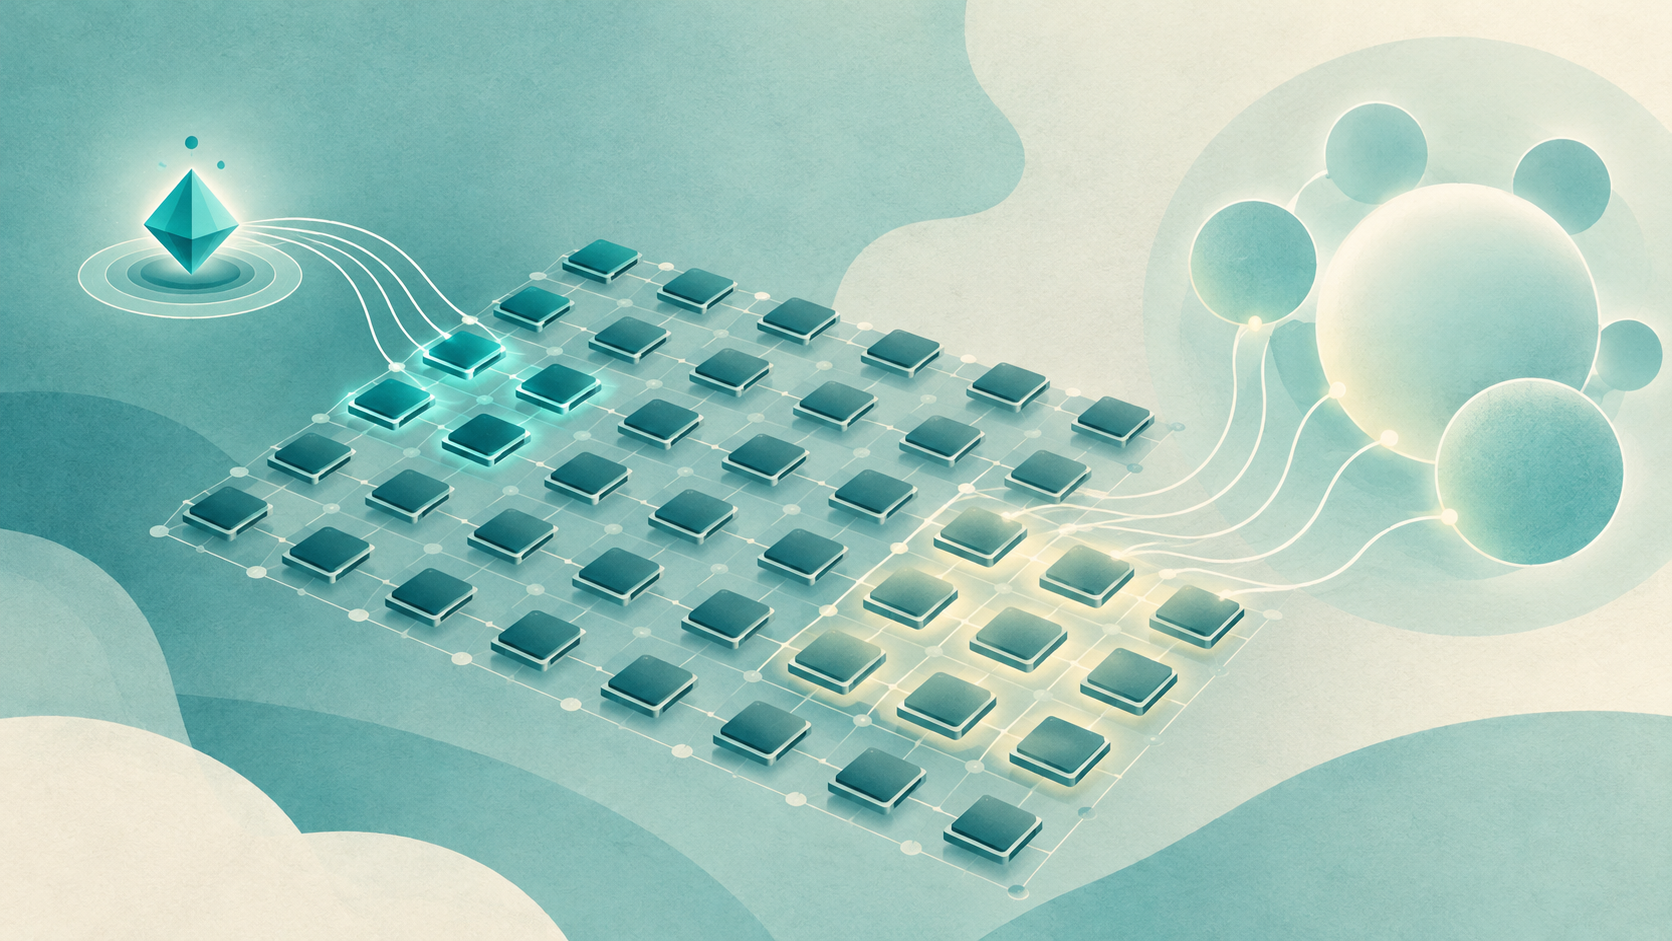
GPUを1枚のまま「急ぎの処理」と「重い背景処理」で共用すると、優先度を上げても急ぎの処理が待たされることがあります。CUDA 13.1でRuntime APIから使えるようになった「Green Contexts」は、GPU内部の計算ユニット(SM)を処理ごとに割り当て、重要な処理のための「専用レーン」を確保できる仕組みです。
NVIDIAが148基のSMを持つBlackwell GPUで行った検証では、優先度だけを使った場合の重要処理のレイテンシー0.140msが、8基のSMを専用に割り当てると0.007ms(約20分の1)になりました。ただし特定のテスト条件での結果であり、AI推論などが一律に20倍速くなるという意味ではありません。この記事では、ストリーム優先度との違い、SMの分け方、導入前の確認ポイントを整理します。

ストリーム優先度とGreen Contextsの違いは?
ストリーム優先度は、たとえるなら「次に空くレジへ優先的に案内する」仕組みです。すでに接客中のレジを途中で空けさせることはできません。一方、Green Contextsは「急ぎの処理用に専用レジを確保しておく」イメージです。
CUDAでは、GPU内のSM(Streaming Multiprocessor)が計算を担当します。ストリーム優先度を上げても、すでにSMで実行中のスレッドブロックを強制的に中断することはできません。背景処理がSMを使い切っていれば、重要処理は空きが出るまで待ちます。Green Contextsでは重要処理に使えるSMを別枠で割り当て、この待ちを減らせる可能性があります。
NVIDIAの比較:重要処理のレイテンシーはどう変わった?
NVIDIAは、148基のSMを持つBlackwell GPUで、重い背景カーネルを動かしながら小さな重要カーネルのレイテンシーを測定しています。条件を変えた3パターンの結果がこちらです。
| 実行方法 | 重要処理のレイテンシー | 特徴 |
|---|---|---|
| 優先度の指定なし | 3.727ms | 背景処理との競合で待ちやすい |
| ストリーム優先度を高く設定 | 0.140ms | 空きSMへの割り当てを優先 |
| Green Contexts+高優先度 | 0.007ms | 重要処理に8 SM、背景処理に140 SMを割り当て |
0.140ms → 0.007msで約20分の1。優先度だけでは埋められない差が出ています。ただし、これは重要カーネルの計測レイテンシーであり、AIモデル全体の推論時間やGPU全体のスループットを示す数字ではありません。背景処理に使えるSMが減るため、両方の処理を測って評価する必要があります。
出典:NVIDIA公式技術解説
Green Contextsが分けるもの
Green Contextsは、処理を実行するGPU資源を指定するための軽量なCUDAコンテキストです。主にSM(計算を実行するユニット)とワークキュー(実行する仕事をGPUへ渡す仕組み)を扱えます。別々のSMに処理を割り当てることで、重要処理と背景処理が計算ユニットを奪い合う状況を緩和します。
ワークキューもポイントです。異なるストリームの仕事が内部で同じキューに載ると、SMに空きがあっても実行が直列化される場合があります。Green Contextsでは想定する同時実行数などをドライバーへ伝え、可能な範囲でキューの競合を避けるようにできます。SMとキューを分けても、必ず同時実行できるわけではありません。
誤解しやすい点:SMの分割はGPUメモリ(VRAM)の容量を分割する機能ではありません。「SMを8:140に分けたらメモリも8:140に分かれる」という意味ではなく、MIGのようなGPUインスタンス単位の分離とも異なります。
変更がホスト側で済む点が実務上重要です。カーネル本体の書き換えは不要で、コンテキスト作成とストリーム作成の部分を、暗黙のデバイス状態に依存せず明示的なハンドル経由へ置き換えます。CUDA 13.1では cudaGreenCtxCreate で得たハンドルを cudaExecutionCtxStreamCreate に渡してストリームを作ります。Driver APIではCUDA 12.4から存在し、Runtime API経由での利用は13.1からの追加です。
Green Contextsを導入する前の4ステップ
- 対応環境を確認:Runtime APIで使うならCUDA Toolkit 13.1以降を前提とし、GPU・ドライバー・利用ライブラリとの適合を実機で確認します。
- 利用可能なSMを照会:
cudaDeviceGetDevResourceでSM資源を取得し、分割に必要な粒度(smCoscheduledAlignmentなど)を確認します。好きな数のSMに無条件で分けられるわけではありません。 - 資源を分けてストリームを作成:
cudaDevSmResourceSplitでSMを分割し、リソース記述子を用意してcudaGreenCtxCreateとcudaExecutionCtxStreamCreateで実行先を指定します。APIの戻り値も確認します。 - 割当と性能を検証:Nsightで分割結果を確認した上で、重要処理のレイテンシーだけでなく背景処理の完了時間・スループットも比較します。
Nsightで「使えるSM数」と「実際の速さ」を分けて確認
採用の前に、意図した割当が実際に成立しているかを確認します。資源の照会は cudaExecutionCtxGetDevResource などのAPIでできます。可視化では、Nsight SystemsはGreen Context別の行へカーネルを並べ、Nsight Computeは割当資源のビットマスクと、そのカーネルが使えるSM数を表示します。
ただし表示されるSM数は「その処理が使える数」であって「実際に使った数」ではありません。実使用数はカーネルの起動形状や同時に走る他の処理でも変わるため、表示だけを見て「これだけ使えた」「速くなった」とは判断できません。
採用判断は「割当」と「両処理の時間」を分ける
ここが判断の要点です。Green Contextsの成否は、次の二つを別々に評価します。
- 割当が成立しているか:資源照会とNsightで、意図したSM分割とコンテキスト間の重なり(意図した分離、または意図した重複)を確認できるか。
- 両処理が時間要件を満たすか:同じ入力・GPU・構成で、重要処理の起動待ちと完了時間、背景処理の完了時間を測る。
SMを分割すると、重要処理と背景処理のそれぞれが使える資源が減るため、実行時間が増える場合があります。重要処理が早く始まっても、背景処理が許容時間を超えてしまうなら、その配分は採用条件を満たしません。公式資料も、異なるSMとワークキューを割り当てても独立処理の並行実行は保証されない、と明記しています。Green Contextsは「並行実行を保証する仕組み」ではなく、「並行実行を妨げる要因を取り除く仕組み」と捉えるのが正確です。
実測するなら、少なくとも「通常優先度」「高優先度のみ」「Green Contexts+高優先度」の3条件を比較します。重要処理のレイテンシーは平均だけでなくp95・p99などの遅い側の値を確認し、背景処理は完了時間とスループットを記録します。入力、GPU、ウォームアップ、測定回数などの条件を揃えることも重要です。
上記は検証方法の提案であり、本記事での実測結果ではありません。最適なSM配分はワークロードごとの検証で決める必要があります。
向く人・向かない人
向くのは、同一プロセス内で複数の独立処理を同じGPUで走らせ、かつホスト側コードを変更できる開発者です。センサー処理や通信・GEMMの重ね合わせのように、重要処理へ「いつ始まるか」が効く場面では、優先度だけでは届かない制御ができます。
反対に、CUDAを呼び出すホスト側コードを変更できない場合や、既存の推論ライブラリに処理を完全に任せている場合は、簡単には適用できません。また、GPUメモリ不足を解決する機能ではありません。背景処理の速度低下が許容できないなら、SMの配分を見直す必要があります。
Green ContextsとMIG・MPSは何が違う?
| 方式 | 主な目的・単位 | 知っておきたい点 |
|---|---|---|
| Green Contexts | アプリ内を含め、処理ごとに使えるSMなどを指定 | カーネル本体は変更不要でも、ホスト側のCUDA制御は必要 |
| MIG | 対応GPUを複数のGPUインスタンスへ静的に分割 | アプリ起動前の設定が基本。GPUインスタンス単位の分離向け |
| MPS | 主に複数プロセスのGPU共有・資源制御 | 従来の使用率制限に加え、CUDA 13.1では静的SM分割にも対応 |
単一プロセス内の「重要処理を背景処理から守りたい」という課題にはGreen Contextsが候補になります。一方、複数プロセスの共有やGPUインスタンス単位の分離を考える場合は、MPSやMIGも比較対象です。詳細な制約はNVIDIAの公式Programming Guideで確認できます。
まとめ:まずは「待ち時間」と「背景処理への影響」を比べよう
ストリーム優先度は「空いたSMへの優先案内」、Green Contextsは「重要処理用のSMをあらかじめ確保する」という違いがあります。NVIDIAの測定例では重要処理のレイテンシーが0.140msから0.007msへ短縮されましたが、これは全てのGPUやアプリの性能向上を保証する結果ではありません。
試す価値があるのは、同じGPUで複数の処理が競合し、CUDAの実行制御を変更できる場合。導入は、実機でSMの割当を確認し、重要処理と背景処理の両方が求める時間・性能要件を満たす場合に判断しましょう。
本記事は2026年10月14日時点のNVIDIA公式資料(技術解説:10月6日公開、Programming Guide:9月10日更新表記)に基づく解説です。筆者による実測ではなく、個別GPU・ドライバー・ライブラリとの適合性は未検証です。
コメント