会議が終わって、録音データをAIで文字起こし。
便利になったなと思いながら議事録を開くと、そこにはこんな表示が。
SPEAKER_00:「来週までに資料をまとめましょう」
SPEAKER_01:「了解しました」
……いや、誰が言ったんだっけ?
複数人の会議をAIで文字起こしすると、こんな場面に遭遇することがあります。発言内容はわかるのに、肝心の発言者がわからない。結局、録音を聞き直すことになれば、せっかくの自動化も少し残念です。
そんな悩みに応えてくれそうなのが、LocalAI 4.11.0で追加された「Name and remember」機能です。
録音から声を明示登録しておくと、同じサーバーが稼働している間は、対応モデルで別の録音の声を照合し、認識できた話者に名前を付けられます。
これはなかなか面白い進化です。
ただし、ひとつ大きな落とし穴があります。
せっかく覚えた名前を、LocalAIは再起動すると忘れてしまうのです。
いったい何ができて、何ができないのか。会議の議事録作成に使えるのか。
今回はLocalAI 4.11.0の新機能を、公式資料をもとにわかりやすく見ていきます。

「SPEAKER_00」が「田中さん」になる!
まず、今回の新機能の面白さを整理しましょう。
AIによる話者分離(Speaker Diarization)は、録音のどの時間帯で誰が話したかを区別する技術です。
ただし、従来の話者分離でわかるのは、基本的に「同じ声の人が話している」ということまで。
その人が田中さんなのか、佐藤さんなのかまではわかりません。
LocalAI 4.11.0では、ここに声を覚えて、次回の録音でも名前を付ける仕組みが加わりました。
例えば、こんなイメージです。
これまで
SPEAKER_00:来週の進捗会議は水曜日にしましょう。
SPEAKER_01:水曜日なら参加できます。
話者を登録した後
田中さん:来週の進捗会議は水曜日にしましょう。
佐藤さん:水曜日なら参加できます。
※上記は機能を説明するためのイメージで、実際の検証結果ではありません。
これなら、議事録を読むときのわかりやすさが変わりそうです。
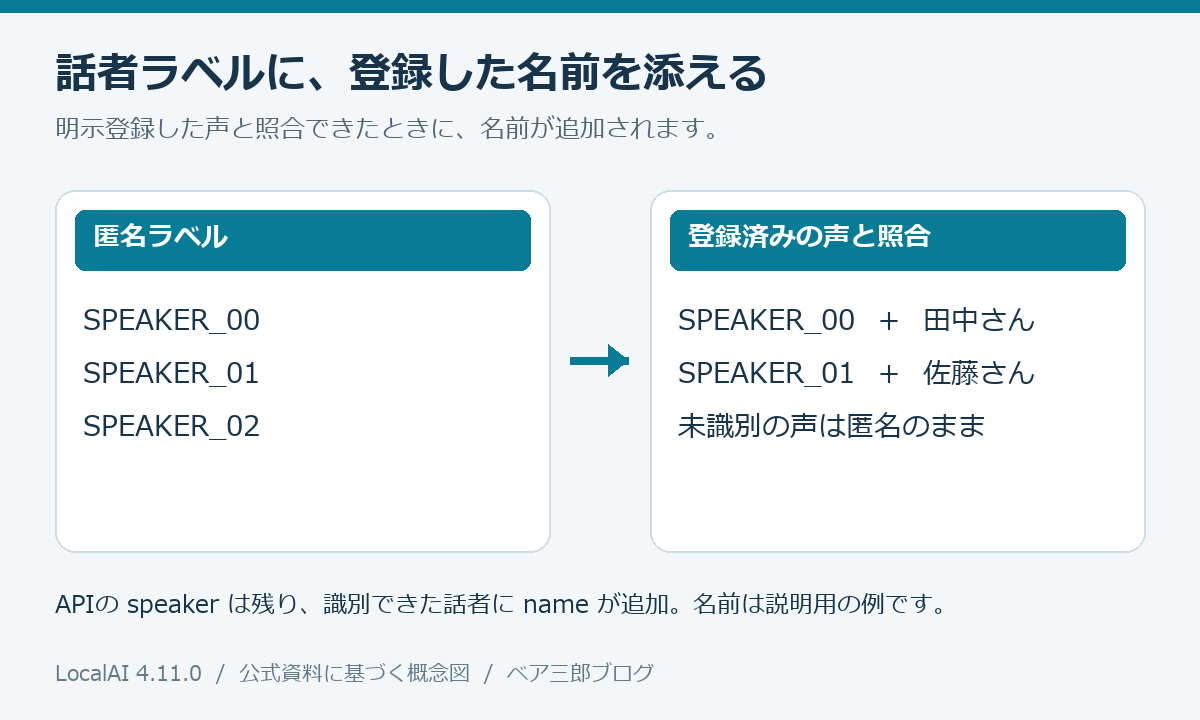
もちろん、すべての声に自動で名前が付くわけではありません。登録されていない人や、うまく照合できなかった人は、従来どおり匿名の話者ラベルで扱われます。
なお、厳密にはAPIの speaker フィールドは SPEAKER_00 のまま残り、識別できた話者に name などの情報が追加される仕組みです。
名前を覚えさせるのは意外と簡単?Studioでの操作
名前を登録するために、全員が専用マイクの前で決まった文章を読み上げる必要はありません。
LocalAIのStudioでは、既存の録音から話者ごとの聞き取りやすい音声区間を取り出し、名前を登録できます。
モデルの重みだけでなく、話者登録に対応するLocalAI本体とparakeet-cppバックエンドも必要です。認証を使う環境では、Audio Diarization権限とモデルへのアクセスに加え、登録にはVoice Recognition権限が必要になります。
公式ガイドで紹介されている操作の流れは次のとおりです。
- 対応モデルをインストールする
Models → Exploreから、話者分離・文字起こし・話者認識に対応したモデルを選びます。例えばparakeet-cpp-nemotron-3-diarization-asr-speakersです。 - 会議の録音を読み込む
Studio → Diarizationを開き、対応モデルを選んで録音ファイルをアップロードします。 - 話者登録の準備を有効にする
「Prepare speakers to remember」を有効にして、「Diarize」を実行します。 - 声を聞いて名前を登録する
Speakers欄で音声のPreviewを聞き、誰の声かを人が確認します。「Name and remember」を選び、名前を入力して「Remember」で登録します。 - 別の録音で認識できるか確認する
同じ認識対応モデルを使って別の録音を処理し、登録した名前が表示されるか確認します。
ポイントは、AIが勝手に全員の声を登録するわけではないこと。
ユーザーが録音を聞き、誰の声なのかを確認して、明示的に登録する仕組みです。
また、声が短すぎたり、別の人の発言が重なっていたりすると、登録に使える音声区間が得られないこともあります。
ただ録音を放り込めば何でも覚える、という魔法のような機能ではありません。
それでも、普段の会議録音から声を登録できるというのは、なかなか実用的な発想です。
ところが、再起動するとAIの記憶が消える
ここからが今回の本題です。
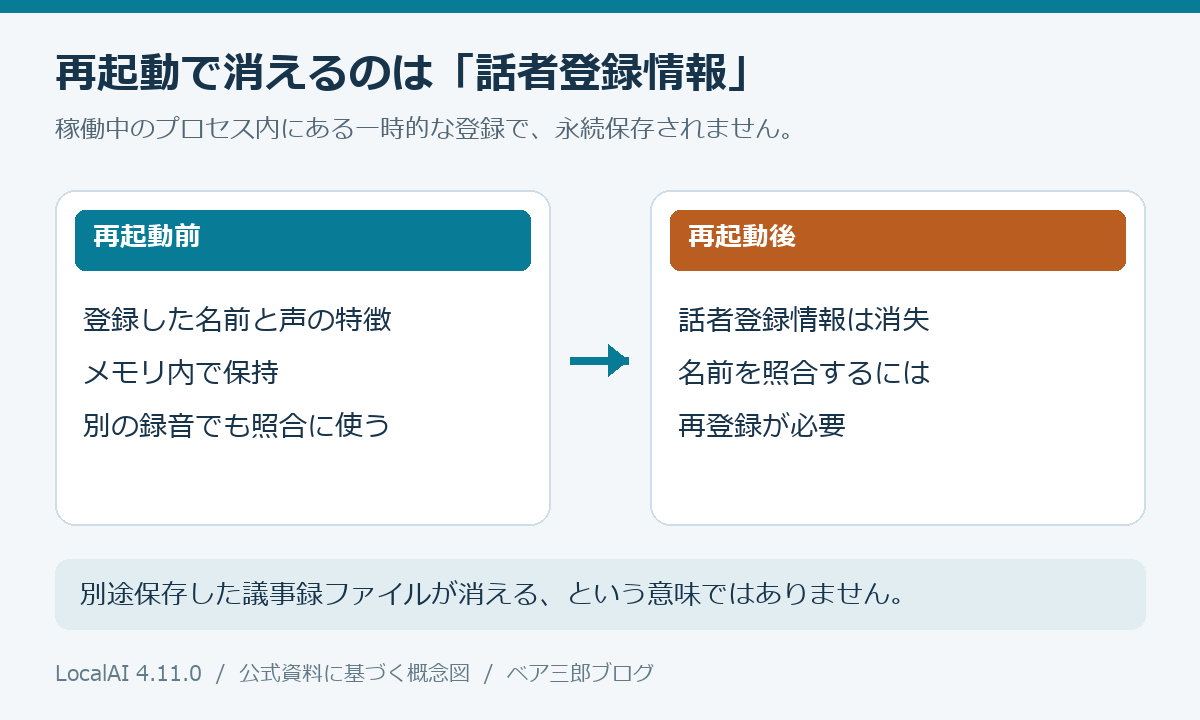
公式リリースには、話者登録情報について「process-local and ephemeral」と明記されています。
少し難しい言葉ですが、要するに登録情報はサーバーのメモリ内にある一時的なもので、永続保存されないということです。
例えば、こんな運用を想像してみてください。
金曜日、部署の定例会議で田中さん、佐藤さん、鈴木さんの声を登録。
別の録音でも名前が表示され、「これは使えそう!」と手応えを感じます。
ところが週末、メンテナンスのためLocalAIを再起動。
そして月曜日、再び会議録音を処理すると……。
登録していた話者情報は、もうありません。
再び声を登録する必要が出てきます。
これは、単に画面上の名前が非表示になったという話ではありません。名前と声を照合するための登録情報自体が、再起動で失われる仕様なのです。
なお、別途保存した議事録ファイルまで再起動で消えるという意味ではありません。失われるのはLocalAIが保持する話者登録情報です。
毎日使う会議録作成システムとして考えるなら、この違いはかなり重要です。
サーバーを再起動するたびに登録し直す必要があるとしたら、便利な機能も運用の負担になってしまいます。
実はもうひとつ注意点が。覚えた声は「みんなのもの」
再起動で忘れる一方、動いている間は別の意味で記憶力が良すぎるところもあります。
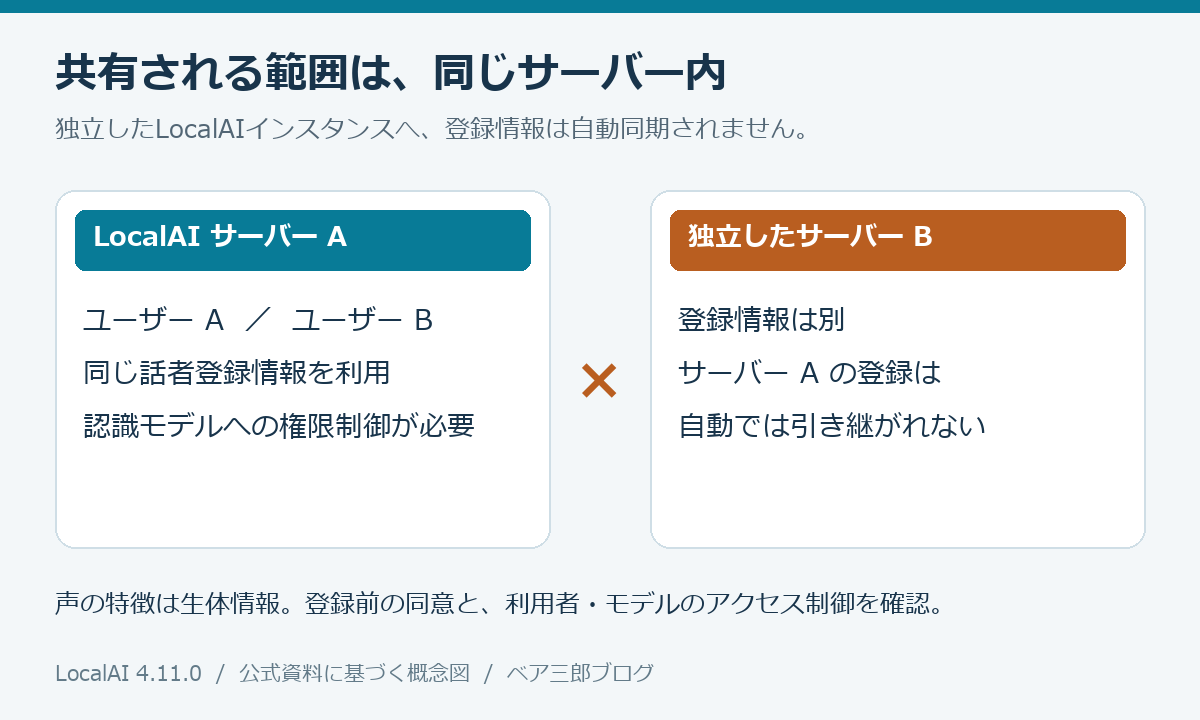
登録された話者の声は、同じLocalAIインスタンスを利用するユーザー間で共有されるのです。
例えば、部署Aの担当者が田中さんの声を登録したとします。
同じLocalAIサーバーを使う部署Bのユーザーも、アクセスできる認識モデルに録音を渡すことで、登録された田中さんの名前を照合結果として知り得ます。
これは便利な面もあります。
部署全体で同じ参加者の声を認識したいなら、個人ごとに登録する手間を減らせるからです。
ただし、反対に考えるとどうでしょう。
会議の参加者や話者の名前を、関係のない利用者にも推測される可能性があります。
公式ドキュメントも、登録された声を共有する仕組みと、モデルへのアクセス制御の必要性を説明しています。
しかも、声の特徴を表す話者プロファイルは生体情報です。
会議録音に使う場合は、参加者から利用目的を含めた同意を得ること、登録する声を必要最小限にすること、認識モデルの利用権限を制限することが重要になります。
なお、ブラウザーには登録一覧用のIDや名前、登録日時が保存される場合がありますが、音声や声の特徴量そのものを保存する仕組みではありません。ブラウザー側の一覧情報も、サーバーの登録情報を永続化するものではありません。
「ローカルで動いているから安全」と単純には言えないところです。
モデルを変更すると、それまでの名前が使えなくなる?
もうひとつ、エンジニアなら気になるのがモデルの更新です。
4.11.0の公式リリースは、声の特徴を抽出するエンコーダーの識別情報が、登録時と認識時で一致する必要があると説明しています。
対応するparakeet-cpp構成では、speaker_model、またはバンドルモデルの speaker_component などを利用します。
ここで、声の特徴を抽出するモデルを別のものに差し替えたらどうなるでしょうか。
モデルが違えば、同じ人の声でも抽出される特徴が変わる可能性があります。
公式仕様でもエンコーダーの識別情報の一致が求められるため、更新や量子化などでモデルの内容が変わった場合、以前の登録情報をそのまま使えるとは限りません。
つまり、将来的に登録情報の永続化が実現しても、モデル更新後の互換性まで保証されるとは限らないわけです。
なお、認識の調整には speaker_threshold や speaker_margin というパラメータもあります。ただし公式ドキュメントでは、文字起こしを含む include_text=true の名前付けでは標準のしきい値が使われると説明されています。
精度を調整する際は、リクエスト方式によって設定の適用範囲が異なる点にも注意が必要です。
会議録音に使うなら、まず何を試すべき?
ここまで読むと「結局、実用的ではないの?」と思うかもしれません。
個人的には、試す価値は十分にある機能だと感じます。
ただし、現時点で本番の議事録システムを置き換えるというより、まずは小規模な実証で使い勝手を確認したい段階です。
特に確認したいのは、次の3つの場面です。
まずは、普通の会議でどこまで正確に名前が付くか。
マイクに近い人と遠い人、声が似ている人、同時に話し始める人。実際の会議は、AIにとって都合のよい音声ばかりではありません。
発言が重なった場合などには誤認識の可能性があるため、名前が付いたからといって本人確認までできたわけではありません。
次に、LocalAIを再起動したときの振る舞い。
これは仕様が明確なので、登録前後の状態を比較することで、運用上どのような再登録作業が必要になるか確認できます。
最後に、複数ユーザーで利用したときの挙動。
同じインスタンスでは話者情報が共有されます。一方、独立したLocalAIインスタンス間では登録情報が自動同期されません。
この違いが、実際の業務フローにどう影響するかを見ておきたいところです。
さらに、日本語の認識精度、長時間録音での処理性能、複数話者の誤識別率なども、利用するモデルとハードウェアに合わせて確認したい項目です。
まとめ:AIが「誰の声か」を覚える時代。でも記憶の保存はこれから
LocalAI 4.11.0の話者登録は、単なる文字起こしから一歩進んだ、興味深い機能です。
これまでは「誰かが話した」までだったものが、登録した声を使って「田中さんが話した」と扱えるようになりました。
会議録音だけでなく、インタビューやポッドキャストなど、同じ人が繰り返し登場する音声コンテンツでも活用が期待できます。
一方で、現時点の登録情報はメモリ内にあり、再起動すると消えてしまいます。複数の独立したインスタンス間での共有にも対応していません。
実際の業務で継続利用するには、登録情報の永続化、アクセス制御、誤認識への対処といった課題が残ります。
それでも、「誰の声かを覚える」という方向性そのものは面白いものです。
名前を付けられるAIから、名前を覚え続けられるAIへ。
LocalAIが次にその壁を越えてくるのか、注目したいところです。
参考資料
LocalAI公式ブログ:Remember speakers from your recordings
LocalAI公式ドキュメント:Speaker Diarization
本記事は2026年10月14日時点の公式資料に基づいています。
LocalAI公式ドキュメント:Voice Recognition(共有範囲・しきい値・制約)
本記事は公式仕様をもとにした解説で、実機での話者登録・精度・日本語文字起こしの検証は行っていません。日本語の会議録音では、文字起こしモデルの対応言語を別途確認してください。
コメント