Googleが新しいAIモデル「Gemini 4 Argon」を一般公開しました。
高度な推論やプログラミング能力が注目されていますが、個人的に興味深かったのは、Googleが公開した実際の開発現場での検証結果です。
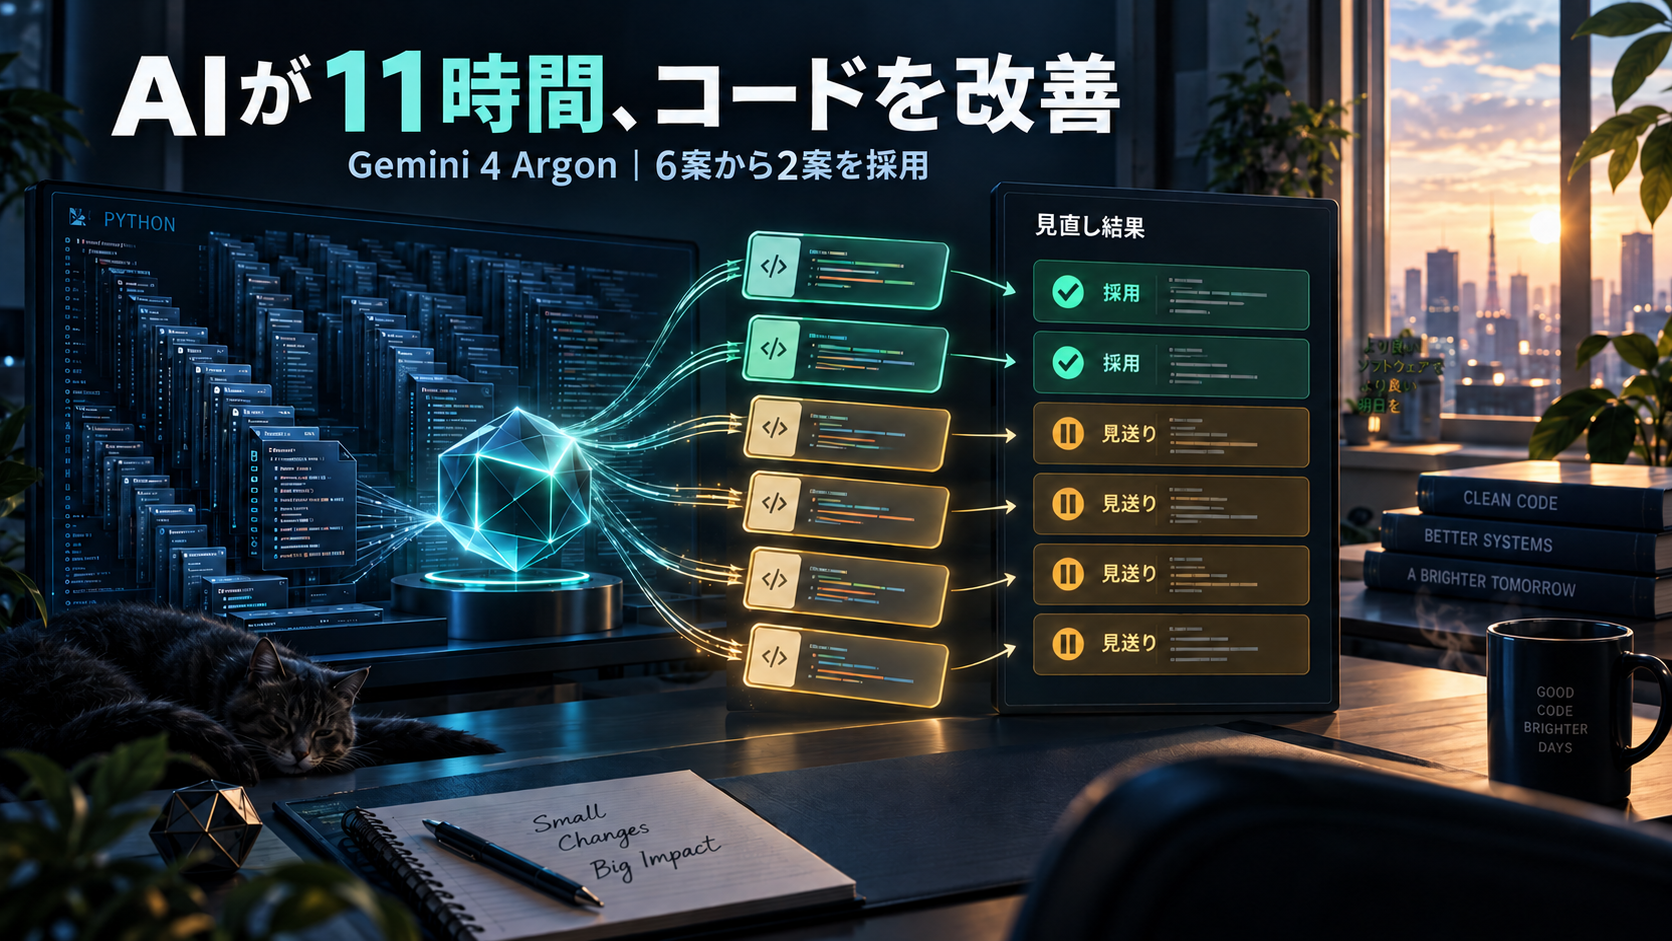
約20万行のPythonコードを対象に、AIエージェントを11時間動かして性能改善に挑戦。その結果、提案された6つの改善案のうち、実際に採用されたのは2つだけでした。
残り4つは、人間のエンジニアによるレビューで却下されています。
AIは本当にプログラマーの仕事を任せられる存在になったのでしょうか。今回の事例には、その可能性と限界の両方が表れています。

Gemini 4 Argonとは?Googleの最新AIモデル
Googleは2026年10月13日、Gemini 4 Argonの一般公開と、対応サービスでの世界各地への順次提供を発表しました。この記事では、同日公開されたGoogle Developers BlogのADK改善事例に絞って見ていきます。
特徴は、単純な質問応答よりも、複数の工程を伴う複雑な作業に重点を置いていることです。
例えば、既存プログラムの調査、問題点の特定、コードの変更、テストといった、一度の回答では終わらない作業を想定しています。
Googleによると、プログラミングだけでなく、金融、法務、サイバーセキュリティ、科学研究なども重点分野です。
つまり、今回の進化は「質問にうまく答えるAI」から「まとまった仕事を進めるAI」への移行にあるといえます。
約20万行のコードを、AIが一晩かけて調査
今回Googleが検証対象に選んだのは、AIエージェント開発用のオープンソースフレームワーク「Agent Development Kit(ADK)」です。
約20万5,000行、800近いソースファイルで構成され、およそ1万7,000件の単体テストを備える実際のソフトウェアです。
Googleの開発チームは、Gemini 4 Argonにプログラムの処理負荷を減らすという目標を与えました。
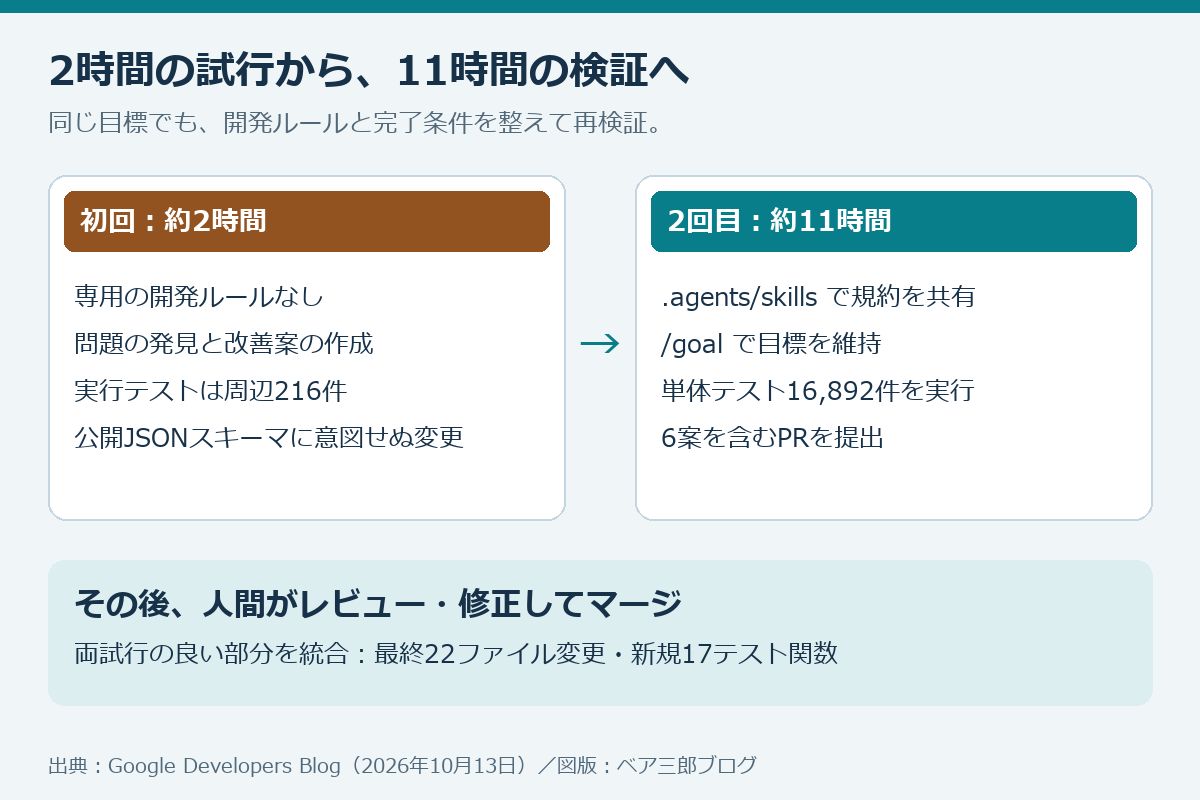
最初の約2時間の検証では、AIは性能上の問題を見つけたものの、公開APIの仕様を意図せず変更するなどの問題を起こしました。テストも周辺の216件しか実行していませんでした。
そこで2回目の検証では、リポジトリ内の .agents/skills に開発ルールを用意し、守るべき設計方針やテスト要件をAIに読ませました。
さらに、Antigravityの /goal モードを使い、長時間の作業でも当初の目標を維持できるようにしています。
その結果、AIは約11時間にわたって作業を続け、16,892件の単体テストを実行し、プルリクエストを提出しました。
ただし、ここで仕事が完了したわけではありません。人間の開発者がレビューし、2回の試行の良い部分を統合して修正しました。最終的にマージされたのは22ファイルの変更と新規17個のテスト関数で、AIが提出した6案をそのまま全部採用したわけではありません。
改善提案は6件。でも採用されたのは2件
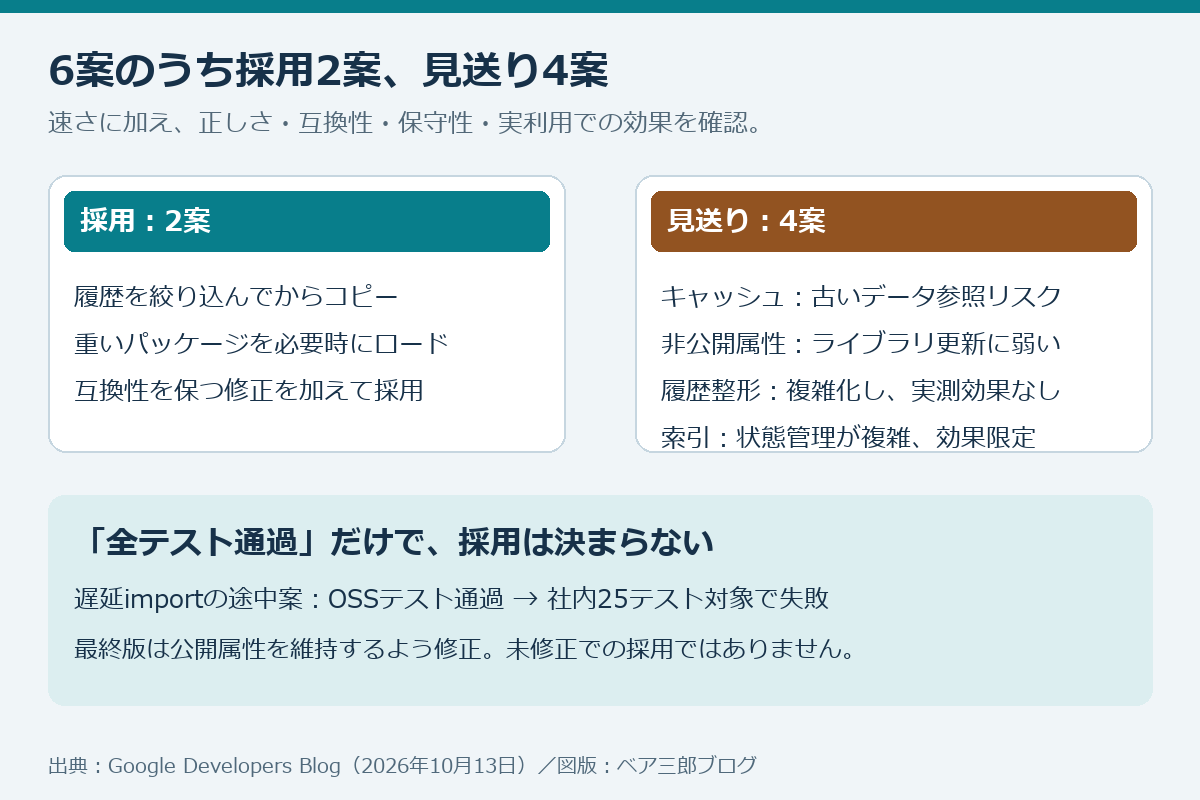
Googleの技術者が翌朝レビューしたところ、AIが提案した6件の改善のうち、実際に採用されたのは2件でした。
採用された改善は、次のようなものです。
1. 会話履歴の無駄なコピーを減らす
AIエージェントは処理を進めるたびに、過去の会話や実行履歴を参照します。
従来の処理には、必要な履歴を絞り込む前に大量のデータをコピーしてしまう部分がありました。
AIは処理順序を見直し、不要なコピーを減らす方法を提案しました。
2. 必要なライブラリだけを読み込む
プログラムの起動時に、すぐには使わない機能まで読み込んでいたことも改善対象になりました。
必要になった段階で読み込む遅延ロードを採用することで、初期処理を軽くしています。
Googleが公開した検証結果は次のとおりです。
| 評価項目 | 結果 |
|---|---|
| 長いセッションでのメモリ内セッション準備 | 約40%短縮 |
| パッケージのインポート時間 | 約21%短縮 |
| 158ターンの処理時間 | 65.6秒 → 56.1秒 |
ここで注意したいのは、AIモデルそのものの回答速度が40%向上したわけではないことです。
約40%短縮されたのは、長い会話でのInMemorySessionServiceによるモデル要求前の準備処理です。Googleは、AIに見せていない独立ベンチマークで、モデルとツールの応答を即時にしてADK自体の処理負荷を測定しました。公表値は6〜12回の測定の中央値です。
また、158ターンはユーザーとの158往復ではありません。ADK内でツール呼び出しなどを行う内部ステップです。65.6秒から56.1秒への短縮も、この条件でのフレームワーク負荷の測定結果です。
また、新規プロセスの起動から最初のモデル要求までの時間は、約3.07秒から3.09秒とほぼ変わりませんでした。外部データベースを使うセッション管理にも、今回の履歴コピー改善は直接適用されません。
性能向上の数字を見るときには、何を測定した結果なのかが重要です。
なぜ残り4件は却下されたのか
実は、今回の検証で最も参考になるのは、採用された2件よりも却下された4件かもしれません。
- マルチエージェントのイベントキャッシュ:合成ベンチマークでは17%高速化しましたが、弱参照とメモリアドレスの再利用により、別セッションの古いデータを返すリスクがありました。
- テレメトリーの確認処理:OpenTelemetryの非公開属性に依存し、ライブラリの小さな更新でも動作が壊れるおそれがありました。
- 会話履歴の整形処理:主要なコードが読みにくくなった一方、独立ベンチマークで全体の遅延を改善できませんでした。
- ワークフロー再生用の索引:状態管理が複雑になり、効果も合成リプレイテストに限られていました。
さらに、採用された遅延ロードも無修正で通ったわけではありません。途中の案は16,892件の公開テストを通過しましたが、削除した内部インポート先の属性を差し替えるGoogle社内の25テスト対象で失敗しました。最終版では、必要時にモジュールを読み込みながら、従来の属性をテストから参照・差し替えできるよう修正しています。
テストが全部通ったことと、既存機能が壊れていないことは、必ずしも同じではありません。
AIコーディングを仕事に取り入れるなら、覚えておきたいポイントです。
AIコーディングで真似したい3つのこと
今回のGoogleの取り組みは、個人開発や業務システムの保守にも参考になります。
1. 作業の目標と禁止事項を明確にする
「処理を速くして」だけでは不十分です。
「公開APIは変更しない」「既存の動作を維持する」「変更には回帰テストを付ける」といった制約を伝えることで、AIの提案を実用的な方向へ導けます。
2. AIに開発ルールを読ませる
Googleは .agents/skills にルールを整理しました。
既存のコーディング規約や設計上の注意点をAIに参照させる方法は、長期間保守するソフトウェアほど効果が期待できます。
3. AIが見ていないテストでも評価する
AIが自分で作成したテストだけでは、改善を過大評価するおそれがあります。
GoogleはAIに見せていない独立したベンチマークも利用しました。
同じ考え方で、既存の回帰テストや本番に近い条件での性能測定を用意しておくことが大切です。
Gemini 4 Argonの利用条件とAPI料金
Googleの日本語発表は世界各地での順次提供を案内しています。GeminiアプリとGoogle検索のAIモードはGoogle AI Pro/Ultra向け、今回の開発事例で使われたAntigravityはUltra向け、Gemini APIは有料枠という違いがあります。日本のすべてのアカウントで、発表直後から同じ機能が使えると確認されたわけではありません。
APIの導入価格は2026年11月30日まで、入力100万トークンあたり2米ドル、出力100万トークンあたり10米ドルです。12月1日以降はそれぞれ4米ドル、20米ドルとなります。出力料金には思考(thinking)トークンも含まれます。長時間のエージェント実行を試すときは、処理時間だけでなくトークン使用量も確認したいところです。
アプリの月額プランとAPIの従量課金は別です。Proへの加入だけで、API料金が無料になったり、Antigravityで今回と同じ利用枠を得られたりするわけではありません。現在の提供条件と料金は、Gemini API公式ガイドとGoogleの一般公開案内で確認してください。
まとめ:AIにコードを書かせるより、成果をどう評価するか
今回のGoogleの事例は、AIコーディングの進歩を示す一方で、AI任せにする難しさも教えてくれます。
11時間動いたAIは、複雑なコードベースから改善点を発見し、実際に性能を向上させる変更を提案しました。
一方、魅力的な数字が出ていても、将来の不具合や保守上のリスクを理由に人間が却下した提案もあります。
この事例を見る限り、現時点で有効なのは、AIにすべてを丸投げする方法ではなく、AIに調査と改善案の作成を任せ、人間が採用基準と品質を管理する方法でしょう。
Google自身の事例であり、ほかの開発環境でも同じ成果が得られると証明されたわけではありません。それでも、AIエージェントを実際の開発に組み込む際の具体的な参考例になっています。
AIが長時間働けるようになった今、次に考えるべきなのは、作業時間の長さよりも、正しい成果だけを残せる仕組みなのかもしれません。
参考資料
- Google Developers Blog:Optimizing a 200,000-line Python codebase overnight with Gemini 4 Argon
- Google公式:Gemini 4 Argon 一般公開
- Google AI for Developers:Gemini 4 Argon 開発者向け仕様・料金
※2026年10月15日時点の公式情報に基づきます。Googleの公表した測定結果を紹介したもので、当ブログでの実機検証は行っていません。効果をほかのコードベースへそのまま一般化することはできません。
コメント