「DGX Sparkを4台つなげば、共有メモリは合計512GB。約510GBのDeepSeekだって動かせそう」——数字だけを見ると、そう考えたくなります。
ところが、いざ起動すると重みの読み込みが極端に遅くなったり、ほかのマシンの準備を待ったままタイムアウトしたり。AIモデルは、ファイルのサイズがメモリ容量に収まれば起動できる、というほど単純ではありません。
面白いのは、今回紹介する4台構成が最終的には起動に成功していること。NVIDIAの開発者フォーラムには、DeepSeekを動かして高い推論性能を記録した人が、その途中でハマった落とし穴まで詳しく公開しています。
今回は、うまくいった成果と起動時のトラブルをセットで見ながら、「何が起きたのか」「自分ならどこを確認するか」を整理します。

まず驚いたのは、4台リング構成で出た性能
2026年10月19日のNVIDIA Developer Forumsへの実機投稿では、中国市場向けDGX Spark相当機「FusionXpark GB10」を4台使用。各機のユニファイドメモリは128GBで、4台の合計は512GBです。
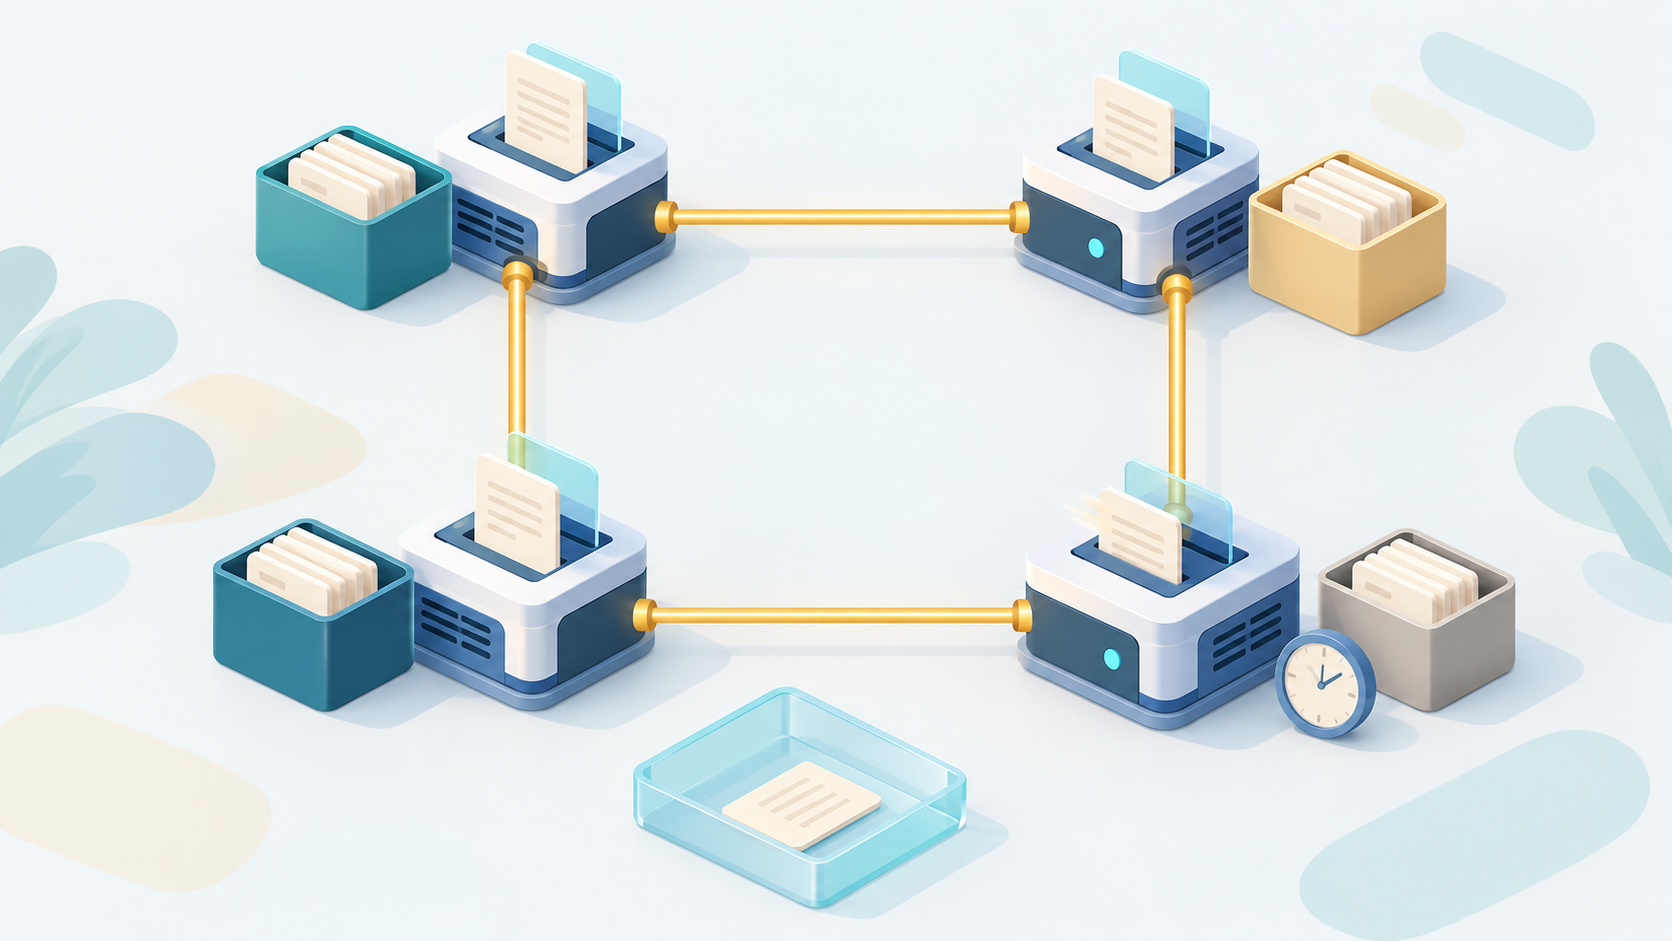
構成が少しユニーク。高価なネットワークスイッチを使わず、4台をケーブルで輪のようにつないだ「スイッチレスリング」です。推論エンジンはSGLang、モデルはDeepSeek-V4.1-Flash-1017。公式チェックポイント(約510GB)を追加で量子化せずに利用しています。
- 単一ストリームのコード生成:定常区間で約90 tok/s
- 8並列のコード生成:合計296 tok/s
- 約100万トークンの入力処理:約5.8分(投稿者の計測条件)
数字は投稿者の測定値で、ベア三郎が実機追試したものではありません。特に「90 tok/s」は定常区間の値で、リクエスト全体の平均速度とは区別する必要があります。
つまり「Sparkを4台使ってもDeepSeekは動かない」というニュースではなく、「動いた。ただし、起動を安定させるには別の難しさがある」という報告なのです。
落とし穴① 512GBあっても、読み込み途中にメモリが足りなくなる
最初の問題は、モデルの重みを読み込んでいる途中のメモリ使用量でした。
投稿者が高速読み込みをEP_SIZE=2で利用すると、4台とも使用量が約118〜119GBに達し、報告上の利用可能な約119GBにほぼ張り付いたそうです。重みのシャードを読む時間も、約3秒から20〜50秒へと悪化しました。
ここで出てくるEPはExpert Parallelism(MoEモデルのエキスパートを分散する仕組み)、TPはTensor Parallelism(テンソルを分割して処理する仕組み)のことです。分散のさせ方が違えば、各ノードで保持する重みや一時的なデータ量も変わります。
投稿ではEP_SIZE=1とTPによる分割に切り替えた高速読み込みで、約3分で起動できたとしています。ただし、これは当該モデル・SGLangイメージ・4台構成での結果。そのまま別の環境にも当てはまる「正解設定」ではありません。
しかも約510GBというのはチェックポイントのファイル容量です。今回の構成では各ノードのローカルストレージにも重みを置いています。ディスク上のファイル容量、各ノードに割り当てる重み、OSや推論エンジンが使うメモリ、一時バッファやKVキャッシュは、別々に考える必要があります。128GB×4という足し算だけでは余裕を判断できないわけです。
落とし穴② 3台は準備完了。でも最後の1台が来ない
もう一つは、メモリ不足とは違う「待ち合わせ」の問題です。
重みを変更して再起動した際、4台のうち3台はキャッシュから素早く読み込みを終え、post-load barrierという同期地点で待機。一方、残る1台はまだディスクから重みを読み込んでいました。結果として、待機していた側が約8分でタイムアウトしたと報告されています。
ここでいうwarm(ウォーム)は、直前の読み込みなどによってOSのページキャッシュにデータが残っている状態。cold(コールド)は、必要なデータを主にストレージから読み込む状態です。推論時に過去の入力を使い回す「prefix cache」とは別の話なので、混同しないようにしたいところです。
投稿者は、4台すべてのキャッシュ状態をそろえて起動すると回避できたとしています。分散処理では、速い3台があっても、遅い1台に全体が引きずられる。なかなか厄介な落とし穴です。
公開レシピにある「直列読み込み」は何を防ぐのか
今回使われたMiaAI-Labのスイッチレスリング構成ガイドには、DSV41_SERIAL_WEIGHT_LOAD=1という設定が登場します。
これは、重みを非同期にコピーしようとして処理待ちのコピーが増え、GB10のCPU/GPU共有メモリにチェックポイントのページが保持され続ける問題を抑えるためのもの。乱暴にいえば、「一度に読み込みすぎないようにする」ための工夫です。
ただし、このフラグはこのリポジトリの実装に依存し、標準のSGLangすべてで使える汎用オプションではありません。ガイドも、すべてのモデルやコンテキスト長でメモリ不足を防げるとは説明していません。
さらに、4台をスイッチなしのリングで動かすこと自体に、対応するパッチ適用済みNCCLが必要です。通常のNCCLにNCCL_ALGO=Ringだけ指定すれば再現できる、という構成ではない点にも注意が必要です。
もし自分の環境で詰まったら、どこを見る?
原因をいきなりネットワークやモデル容量のせいにせず、まず「最初に何が失敗したか」を確かめるのが近道です。
- 最初のエラーを確認:メモリ確保・重み読み込みの失敗か、barrierのタイムアウトか、それともNCCLの通信確立エラーかを分ける。
- 4台の時系列を並べる:各rankの読み込み開始・完了時刻を記録し、1台だけ遅れていないか確認する。
- ノードごとのメモリ推移を見る:GPU側の使用量だけでなく、共有メモリやOSのキャッシュも含めて比較する。
- 条件の一致を確かめる:モデルrevision、SGLangイメージ、
EP_SIZEやTP設定、ローカル重みの配置をそろえる。 - 変更は一度に一つずつ:キャッシュ状態、読み込み方式、同期のタイムアウトを全部同時に変えず、どれが効いたか検証する。
とくにbarrierのタイムアウトを長くするだけでは、メモリの逼迫や読み込みの偏りといった根本原因は解消しません。また、今回の「4台リング」という通信条件に特有の問題と、1台でも起こりうるメモリ問題は分けて考える必要があります。
まとめ:モデルを「載せる」だけでは終わらない
4台のGB10でDeepSeekが動いた、という成果だけでも十分すごい話です。でも今回、個人的に興味深かったのは、その「動く」までの道筋が、メモリ容量の計算だけでは説明できないことでした。
今回のポイントは2つ。①重みの読み込み中に一時的なメモリ圧力が高まること、②ノード間のキャッシュ状態が違うと同期で待ち続けること。どちらも最終的には「起動しない」に見えますが、調べる場所も対処の考え方も異なります。
今後、ローカルLLMを複数台に広げる人ほど、この2つを知っておく価値がありそうです。起動ログを見るときは、モデルのサイズだけでなく、各ノードが「いつ」「どれだけ」読み込んでいるかに注目したいですね。
出典・検証範囲:NVIDIA Developer Forumsの2026年10月19日付実機投稿、およびMiaAI-Labの公開構成ガイド(2026年10月20日確認)。数値・トラブル・回避方法は投稿者の報告に基づきます。ベア三郎自身による起動再現や独立追試は行っていません。公開リポジトリのmainブランチは後日変更される可能性があります。
コメント