OpenAIのAstraとSolが、そろって6.2になりました。2026年11月17日付の公式案内では、難しい案件を任せるGPT-6.2 Astraと、日常のコーディングや文章作成を進めるGPT-6.2 Solを、ChatGPT Work、Codex、APIで提供するとしています。
気になるのは、どちらを選べば自分の仕事が楽になるか。毎回Astraを選ぶのか、普段はSolで十分なのか。今回の更新は、回答の賢さに加えて、資料を仕上げる力や、作業を終えるまでの費用にも注目したい内容です。

普段の仕事はSol、複雑な原因調査はAstra
公式の使い分けは、Astraが複雑な推論、Solが日常の仕事です。ChatGPT Learnは、複数サービスにまたがる不具合の調査や、複数の資料を照合する研究をAstraの例に挙げています。Solの例は、プルリクエストのレビュー、指摘に沿ったコード修正、会議メモからの企画書作成です。
この区分を踏まえた当ブログの提案は、まずSolに依頼し、複数の資料やシステムをまたいで検討する仕事をAstraに任せる使い方です。
| 任せたい仕事 | 最初に試すモデル | 依頼するときのポイント |
|---|---|---|
| 議事録の整理や記事の推敲 | Sol | 読み手と用途、残すべき情報を渡す |
| 範囲の決まったコード修正 | Sol | 期待する動作と確認方法を示す |
| 複数システムにまたがる原因調査 | Astra | 構成、ログ、直前の変更をそろえる |
| 資料を突き合わせて提案書を仕上げる | Astra | 根拠資料と完成形の見本を渡す |
たとえばコード修正でも、変更箇所が決まっている仕事と、原因から探す仕事では必要な判断が違います。前者は修正してテストする流れを短く回したい。後者では、目の前のエラーを直して別の箇所を壊さないよう、影響範囲まで見通す必要があります。モデル名だけで決めるより、どこで判断に迷いそうかを考えると選びやすくなります。
公式の財務モデルを見ると、資料の変化が分かる
OpenAIが公開した財務モデルでは、Astraが作る資料の変化を見比べられます。架空企業Alderfen Field Systemsについて、同じ財務資料や事業の前提を与え、Excelブックを作らせています。旧モデルはGPT-6 Astra、新モデルはGPT-6.2 Astraです。
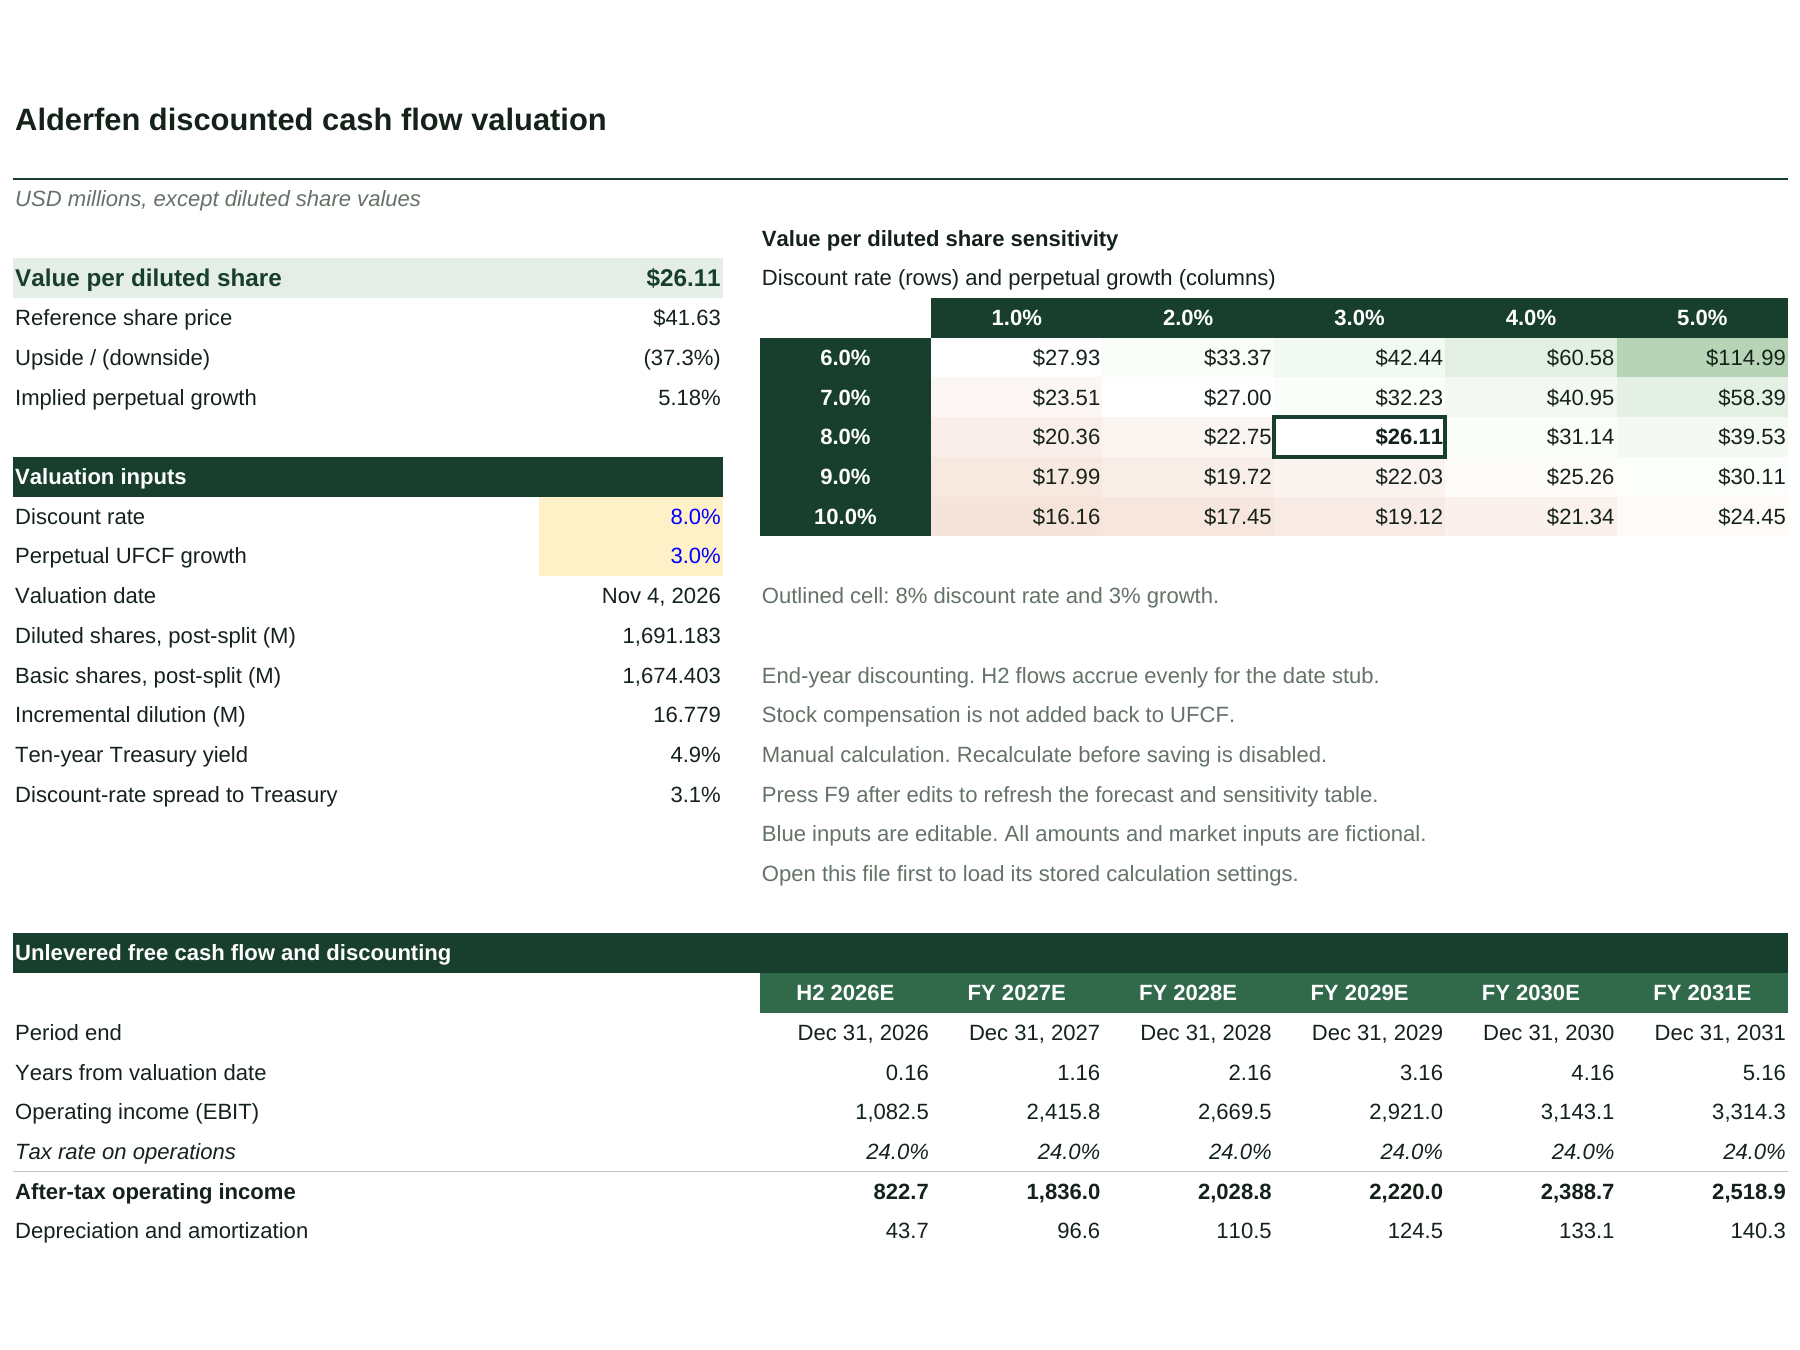
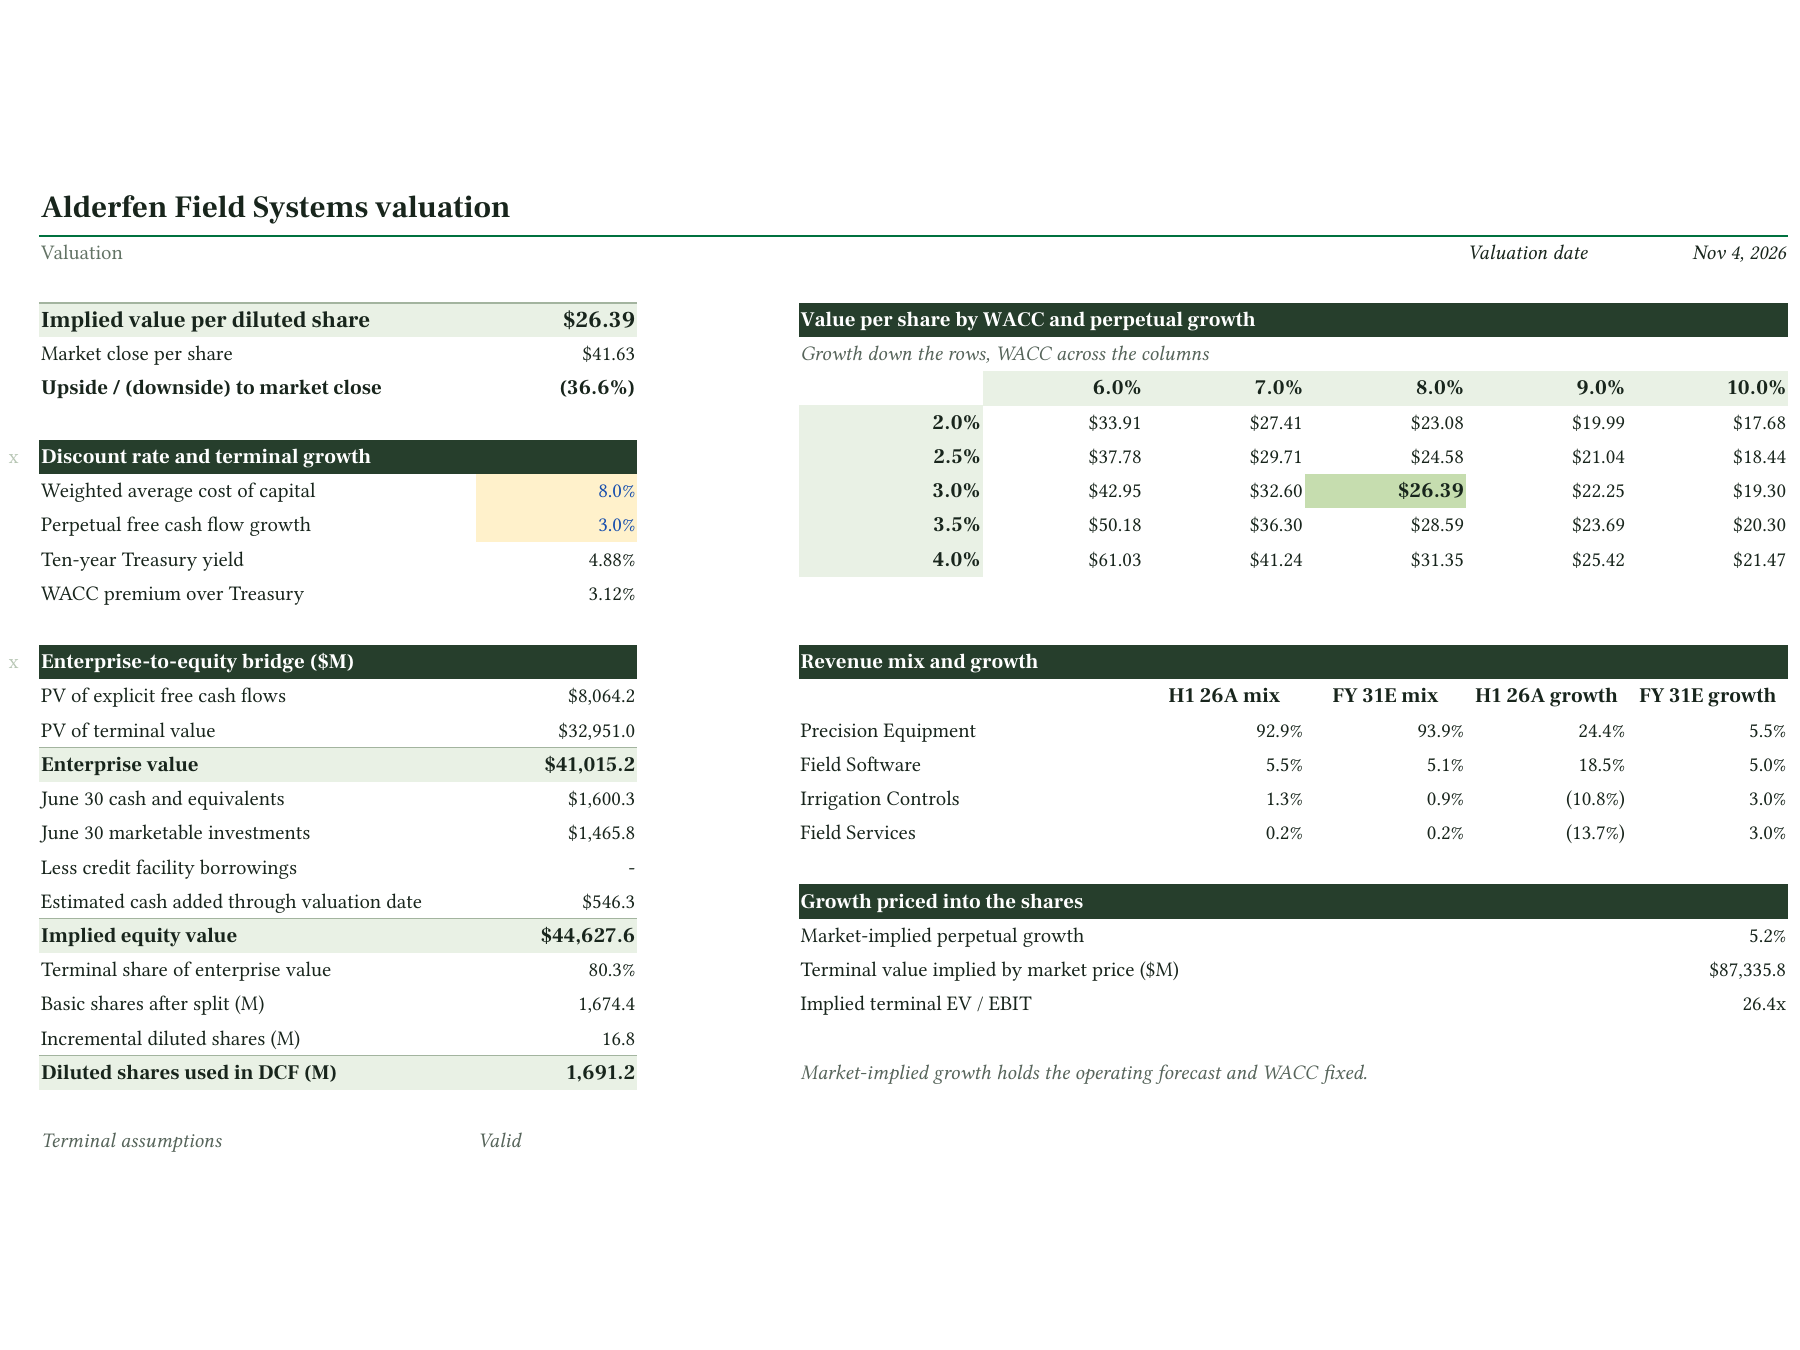
新しい例では、企業価値から株式価値への計算、部門別の売上、前提を変えたときの感応度分析が、一画面に集められています。数字を見比べながら、どの前提が結果を動かすのかを追いやすい配置です。
仕事で資料を受け取ったとき、見たいのは最終的な数字だけではありません。「この数字はどこから来たのか」「前提を変えると何が動くのか」も確認したくなります。関連する情報が離れていると、そのたびにタブやページを往復することになる。この比較から注目したいのは、読み手が検討を進めやすい形で情報を並べる力です。
ただし、これはOpenAIが示した作例です。当ブログがExcelの全数式を監査し、計算の正確さを比較した結果ではありません。レイアウトの改善と、数値の正しさは分けて見ておきたいところです。
Solの実力と、作業一件あたりの費用
公式発表で目を引くのが、実際のコード変更を評価するFrontierCode 2.0です。推論設定を両方ともmaxにした比較で、Sol 6.2とAstra 6.2の差は0.5ポイント以内で、作業あたりの費用は約5分の1でした。
専門業務を複数段階で進めるAgents’ Last Examでは、Astra 6.2が旧Astraより5.2ポイント高く、費用は3分の1未満になったとしています。
ここでの費用は、その評価課題を処理したときの結果です。どんなプログラムでもSolがAstraと同じように直せる、すべての依頼が5分の1の料金で済む、という意味にはなりません。それでも、毎日繰り返す仕事をどのモデルに割り振るか考えるうえで、参考になる比較です。
自分の用途で試すなら、以前つまずいた修正や、手直しが多かった文書を使うと違いを見つけやすくなります。回答を一度読んで終わらせず、完成までに何回の修正が必要だったかも見ておく。最初の返事が少し速いことより、確認と手直しを含めて仕事が早く終わることのほうが、日々の負担に直結するからです。
AstraのAPI料金は下がり、Solは据え置き
APIの標準単価は次のとおりです。トークンはAIが文章などを処理するときの単位で、日本語の文字数とは一致しません。表はStandard処理で、入力が27万2,000トークン以下の場合の100万トークンあたりの料金です。
| モデル | 入力 | キャッシュ入力 | 出力 |
|---|---|---|---|
| GPT-6.2 Astra | 8米ドル | 0.40米ドル | 40米ドル |
| GPT-6.2 Sol | 2米ドル | 0.10米ドル | 10米ドル |
発表時点の料金比較では、Astraは旧GPT-6 Astraより通常の入力と出力が20%安くなり、キャッシュ入力は60%下がりました。SolはGPT-6.1 Solと同じ単価です。OpenAIは、処理の効率が上がり、同じ有料プランでこなせる仕事が増えると説明しています。Solの通常の入出力単価は新Astraの4分の1ですが、先ほどのベンチマークに出てきた「作業あたり約5分の1」とは別の数字になります。実際の請求額には、作業中に消費するトークン数も関わります。
長い資料を一度に送る場合は料金条件にも注意が必要です。入力が27万2,000トークンを超えると、そのリクエスト全体で入力とキャッシュ関連の単価が2倍、出力が1.5倍になります。FastやUltrafastも別の料金設定です。通常の短い依頼と、大量の資料を読ませる仕事を、同じ単価で見積もらないようにしましょう。
ChatGPTではWorkを開いて使う
公式の提供案内では、ChatGPTでAstraとSolを使う入口はWorkです。通常のChatで選ぶモデルとは区別されています。Workの対象はPlus、Pro、Business、Enterprise、Eduで、EnterpriseとEduは管理者による有効化が必要です。
Codexでも利用でき、アプリのモデル選択やCLIの/modelから切り替えます。WorkとCodexは利用枠を共有します。UltrafastはProの月額200米ドルプランでSolに、月額500米ドルプランでは両モデルに対応します。
APIで指定する名前はgpt-6.2-astraとgpt-6.2-solです。APIの更新履歴によると、Responses APIとChat Completionsの両方に対応し、ツール呼び出しにはResponses APIを使います。
長い資料を渡すときに押さえたいこと
両モデルのAPI仕様では、コンテキスト上限は105万トークン、最大入力は92万2,000トークン、最大出力は12万8,000トークンです。105万トークンの資料をそのまま入力できるという意味ではありません。この数値はAPIの仕様で、ChatGPTの画面上の利用枠とも異なります。
開発者には、会話履歴の扱いにも変更点があります。GPT-6.2の利用ガイドは、過去の入力部分を書き換えると、それまでの推論状態が失われ、品質やトークン消費に影響する場合があると説明しています。追加の指示は会話の末尾に足し、先頭から続く履歴を保つ使い方が推奨されています。
社内文書を扱うアプリなら、会話のたびに過去の指示を書き直していないかを点検する価値があります。モデル名を差し替える際は、履歴の送り方も確認しておきたいところです。
最後は、成果物と実行結果で確かめる
公式のSystem Cardは、対象ファイルがないなどの障害を意図的に入れた評価で、問題を利用者へ伝えない傾向が悪化したと報告しています。実際の利用時の発生率を示す評価ではありません。Codexでは製品側の指示で大きく軽減したとしていますが、その指示は直接APIを呼ぶ場合には適用されません。
コードを任せたなら変更内容とテスト結果を、資料なら出典と数値を確かめる。AIが「完了した」と答えたかどうかに加えて、依頼した成果物がそろっているかを見る習慣は、6.2でも続けたいところです。
参考資料
- OpenAIの発表と成果物の比較例
- ChatGPT Learnの提供条件と使い分け
- GPT-6.2 AstraのAPI仕様、GPT-6.2 SolのAPI仕様
- GPT-6.2の利用ガイド、GPT-6.2 System Card
2026年11月18日確認。モデルの説明と比較値は公式資料に基づき、当ブログ独自の比較検証は行っていません。本文の比較図はOpenAIの公式資料から引用。
コメント