「DGX Sparkを2台、3台とつなげば、もっと大きなAIモデルを動かせる!」
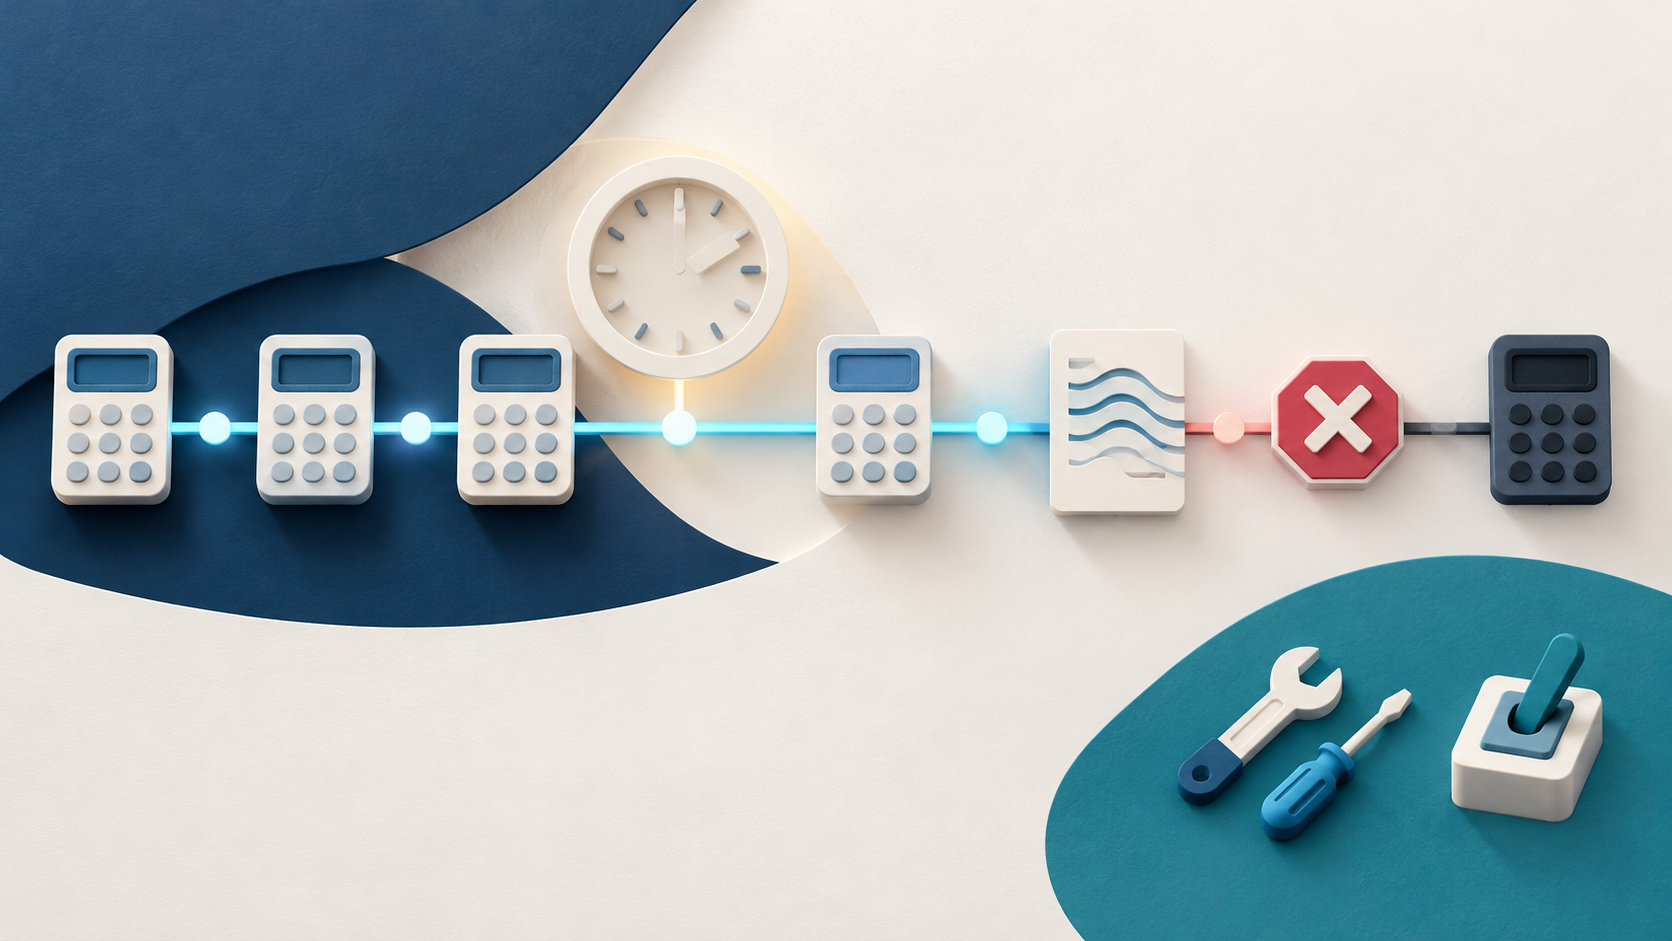
そんなワクワクする構成で、もし1台から突然返事が来なくなったら? 実は怖いのは、AIが止まることだけではありません。通信に失敗したのに、その後の計算が進んでしまうことも厄介なんです。
どうも、ベア三郎です。
2026年10月16日に公開されたコミュニティ製OSS「dgx-spark-networking」のバージョン0.4.0では、通信障害が起きたときの“止まり方”が変わりました。さらに、タイムアウト設定もわかりやすい時間指定に変更されています。
「自分はSparkを1台しか持っていないけど関係ある?」という方も大丈夫。複数台でAIを動かすと何が難しくなるのか、できるだけやさしく見ていきましょう。
※今回の話はNVIDIA公式のDGX Spark本体やNCCL全体のアップデートではありません。複数台のSpark向けに公開された、特定のOSS通信実装についての変更です。

先に結論。「エラーを見つけやすくして、ちゃんと止まる」が大きな進化
0.4.0の変更で、まず押さえておきたいのは次の違いです。
| 比較 | これまで | 0.4.0 |
|---|---|---|
| 通信タイムアウト後 | 後続の通信処理も実質スキップされ、計算が進み得た | 障害情報を記録して、GPU側の処理を停止 |
| タイムアウト設定 | ポーリング回数で指定 | ミリ秒で指定。既定値は10,000ms(10秒) |
| リング構成の中継処理 | 独自の5秒タイムアウト | 通信処理と同じタイムアウトを使用 |
| 障害の調査 | 別のエラーが先に出て、原因を追いにくい場合があった | どの相手との通信で止まったかを記録 |
一見すると「止まるようになっただけ?」と思うかもしれません。でも、複数台のAIサーバーを運用するなら、これは見逃せない改善です。
なぜ、通信エラーでは「無理に続けない」ほうがいいの?
たとえば、3人で1枚の大きなパズルを完成させる場面を想像してください。
1人が担当するピースを渡せなくなったのに、残りの2人が「まあ、そろったことにして次へ進もう」と作業を続けたらどうでしょう。あとになって絵が合わないと気付いても、どこで最初に問題が起きたのか探すのが大変ですよね。
分散推論も少し似ています。AIモデルの計算を複数のGPUで分担し、途中で結果を集めたり、足し合わせたりします。このGPU同士の共同作業が、技術的には「collective(集合通信)」と呼ばれるものです。
従来の実装では、相手ノードからの応答を待つ処理がタイムアウトすると、その通信と後続の通信が何もしない処理(no-op)になり、必要なデータが書き込まれていないバッファを使って計算が進み得ました。
すると、あとからモデル内のNaNチェックなどがエラーを出し、本当は通信が原因なのに、計算側の問題に見えてしまうことがあったのです。
0.4.0では、原因を記録してから停止する
新しい方式では、通信の待ち時間が上限に達すると、どの相手ノード(peer)を待っていたか、どの通信経路(HCAレーン)か、何秒待ったか、どの通信順番(sequence)かを記録します。そのうえでCUDAのtrapを使い、GPU側の処理を異常終了させます。
ここは誤解しやすいところ。DGX Spark本体の電源が落ちるという意味ではありません。通信に失敗した処理を、正常な計算として続行させない仕組みです。
障害記録はCPU側から読み出せる領域(pinned host memory)に残り、failure()で確認できます。一方、check_health()は異常を例外として通知します。vLLM向けの連携部分からもfailure()を呼び出せるようになりました。
つまり、「原因がよくわからないまま後から落ちる」より、「どこで通信が止まったかを残して落ちる」方向に変わったわけです。
タイムアウトが「何回待つ?」から「何秒待つ?」に
もうひとつ、設定する側にはかなりうれしい変更があります。
従来はSPARKNET_ROCE_SPIN_LIMITという変数で、通信を何回確認するかを指定していました。ただ、その回数がDGX SparkのGB10で実際に何秒に相当するかは、変更履歴によると測定されていませんでした。
0.4.0から使うのは、こちらです。
SPARKNET_ROCE_TIMEOUT_MS=10000
単位はミリ秒なので、10,000ms=10秒。しかも、これが既定値です。旧変数SPARKNET_ROCE_SPIN_LIMITはそのまま使えず、新しい名前への変更が必要です。
さらに、set_timeout_ms()によってCUDA Graphのcapture後でもタイムアウトを変更できるようになりました。リング構成の中継処理も、以前の独立した5秒設定ではなく、同じタイムアウトを参照します。
ただし、10秒がすべての環境に最適というわけではありません。初回起動などでノードごとのコンパイルや準備時間が大きくずれるなら、通信を始める前にCPU側で同期しておく設計が重要です。待ち時間だけをむやみに伸ばしても、通信障害そのものが解決するとは限りません。
実はもうひとつ。GPUカーネルもTileLangに一本化
元々の通信障害の話からは少し離れますが、0.4.0には別の大きな変更もあります。
それが、GPUの通信処理を担うカーネルをTileLang版に一本化したこと。従来のCuTe DSL版は廃止され、2種類を並行して保守する状態をやめています。
開発者にとっては、同じ修正を二重に実装・検証する必要がなくなるのがポイント。一方、利用者はTileLangへの依存関係や、廃止されたSPARKNET_ROCE_KERNELSなどの旧オプションを確認する必要があります。
タイムアウトに加え、処理のどこで時間がかかったかを追うトレース機能も変更履歴に記載されています。ただし、これらはアップデートするだけで推論速度が上がると保証するものではありません。
0.4.0へ更新するなら、この5点を確認したい
実際にこのOSSを使って分散推論を組んでいるなら、設定ファイルだけを書き換えて終わりにしないのがおすすめです。
- 旧環境変数の置き換え:
SPARKNET_ROCE_SPIN_LIMITが残っていないか確認する。旧値をそのままミリ秒へコピーしない。 - TileLangの依存関係:CuTe DSL版を前提としたパッケージや、削除・拒否された旧オプションが残っていないか確認する。
- ノード間の起動タイミング:JITコンパイルや準備処理を通信フェーズへ持ち込まず、必要なCPU側の同期を行う。
- 障害記録の取得:相手ノード、通信レーン、待機時間、sequenceをログとして収集できるか試す。
- 復旧手順の確認:推論リクエストへどう失敗を返すか、rankグループをどう再起動するかを決める。
公式の導入ガイドでも、通信タイムアウトはrankグループにとって致命的なエラーで、自動のフォールバックや再接続は行わないと説明されています。検知できることと、自動復旧できることは別なんですね。
ベア三郎のひとこと。「速く動く」だけがAIインフラの進化じゃない
DGX Sparkのニュースというと、どうしても「何Bのモデルが動いた!」「毎秒何トークン出た!」といった性能面に目が行きがちです。もちろん、それも面白いところ。
でも、複数台をつないで運用し始めると、話は変わります。1台が返事をしなくなったとき、何が起きたかを説明できることも、安心して使うための大切な条件なんです。
今回の0.4.0は、まさにその地味だけれど重要な部分に手を入れた更新だと感じました。障害が起きない魔法ではないし、自動で直してくれるわけでもありません。それでも、原因を残して止まれることには価値があります。
ちなみに、Sparkを1台で使う場合の推論速度が気になる方は、以前のDGX SparkでStrataとllama.cppを実測比較した記事もどうぞ。こちらは単体の推論性能の比較で、今回の複数台通信の検証とは別の話です。
「動けばOK」から「止まったときまで設計する」へ。小さなAIマシンを複数台で活用する世界では、こういう進化が効いてきそうですね。
参考資料・検証範囲
※2026年10月17日時点で公開されているv0.4.0の資料に基づきます。ベア三郎による実機での障害注入試験や再現検証は行っていません。説明した動作は該当OSSのものであり、NVIDIA公式のDGX Spark全般やNCCL全体の動作を示すものではありません。
コメント