「ローカルAIを本格的に使うには、高いGPUが必要?」。そう感じている人に、気になるニュースが届きました。手元の端末で、文章に加えて画像や音声を扱う小型AIの選択肢が増えています。
どうも、ベア三郎です。Liquid AIは2026年10月27日、2B級を中心とする新モデル群「LFM3」を発表しました。続いてOllamaとllama.cppも対応を進めています。今回は「何が新しいのか」「日本語で何ができるのか」「試す前に何を確認すべきか」を、公式資料から整理します。[1]
情報確認:2026年11月3日(日本時間)。主に10月27〜28日付の公式発表を扱います。

最初に押さえたい、今回のニュース3点
- LFM3は小型モデルの「ファミリー」。文章用、画像・動画用、音声用、複合入力用を用途に応じて選べます。
- 実行ソフトの対応も前進。OllamaではLinux・Windowsへ対応が広がり、llama.cppでは音声を扱うAPIが拡充されました。
- 「約1GB」と「日本語対応」の読み方に注意。PC全体が1GBで足りるという意味ではなく、日本語の音声処理と音声会話の対応範囲も異なります。
新しさは、モデルの公開だけでなく、普段使う実行環境に載せるための整備が同じ時期に進んだことにあります。[2][3]
LFM3は何者?「文字だけのAI」から選択肢が広がる
LFM3は、共通の言語モデルを土台として、画像や音声を処理する部品を組み合わせたモデル群です。こうした複数種類の情報を扱う仕組みをマルチモーダルと呼びます。開発元は、特定の仕事に合わせた追加学習や端末上での利用を重視しています。[4]
名前が似ていても、扱える入力と文脈の長さは同じではありません。まずは主要4モデルを見比べましょう。
| モデル | 入力 → 出力 | 文脈上限 |
|---|---|---|
| LFM3-1.7B | 文字 → 文字 | 256K |
| LFM3-VL-2B | 文字・画像・動画 → 文字 | 128K |
| LFM3-Audio-2B | 文字・音声 → 文字・音声 | 32K |
| LFM3-Omni-2B | 文字・画像・動画・音声 → 文字・音声 | 32K |
「B」はパラメータ数の十億単位を表します。テキスト版は約17億、ほかの主要モデルは約20億規模です。ただし、モデル名だけでは必要メモリも回答品質も決まりません。なお、画像や動画は入力の対象で、上表のモデルが画像・動画を生成するという意味ではありません。[5][6][7][8]
Ollama・llama.cppの対応で、何が変わった?
Ollama:Linux・WindowsでもLFM3を扱えるように
10月28日付のOllama v0.40.13のリリースノートでは、Apple Siliconに加えてLinux・WindowsでもLFM3が動くようになったと説明されています。対象には、lfm3-audioとlfm3-omniの音声合成も含まれます。[2]
WindowsのPCやLinuxマシンを使っている人にも、試せる入口が広がったわけです。ただし、OSへの対応発表は、あらゆるGPUやPCで同じ速度が出るという保証ではありません。
llama.cpp:音声会話を組み込むための土台が拡充
同じく10月28日付のllama.cpp v0.8.0では、LFM3の文字・画像・音声・Omniモデルへの対応に加え、リアルタイム音声のための/v1/realtime、読み上げ用のPOST /ttsなどが追加されています。ストリーミング音声を扱うmtmdのAPIは、実験的な機能として案内されています。[3]
開発者にとっては、ローカルAIアプリに「聞く・話す」を組み込むための部品が増えた、というニュースです。利用する画面やクライアント側にも対応が必要なので、既存のチャット画面を更新するだけで全機能が使える、とまでは言えません。
日本語で話せる?ここは機能ごとに確認したい
日本語ユーザーにとって、ここが一番気になるところですよね。LFM3-1.7Bは、日本語を対応言語に含んでいます。音声版のLFM3-Audio-2Bも、文字起こし・音声合成・翻訳で日本語を含む多言語対応を掲げています。[5][7]
ただし、Audio版の公式モデルカードは、音声会話(Voice chat)と、話している途中から逐次文字にするLiveASRについては、現時点では英語のみと明記しています。[7]
| LFM3-Audio-2Bの機能 | 日本語についての読み方 |
|---|---|
| 録音の文字起こし・音声合成・翻訳 | 対応言語に日本語を掲載 |
| 音声会話・LiveASR | 公式カードは現時点で英語のみと明記 |
| 自分の録音や専門用語での品質 | 別途評価が必要。本記事では未測定 |
最初の検証なら、短い日本語録音と正しい書き起こしを用意して、固有名詞や数字がどう出るかを見てみたいところ。これはベア三郎からの検証案です。「日本語対応」の一言を、実際に使いたい機能へ分解すると判断しやすくなります。
「4bitで約1GB」は、PC全体の必要メモリではない
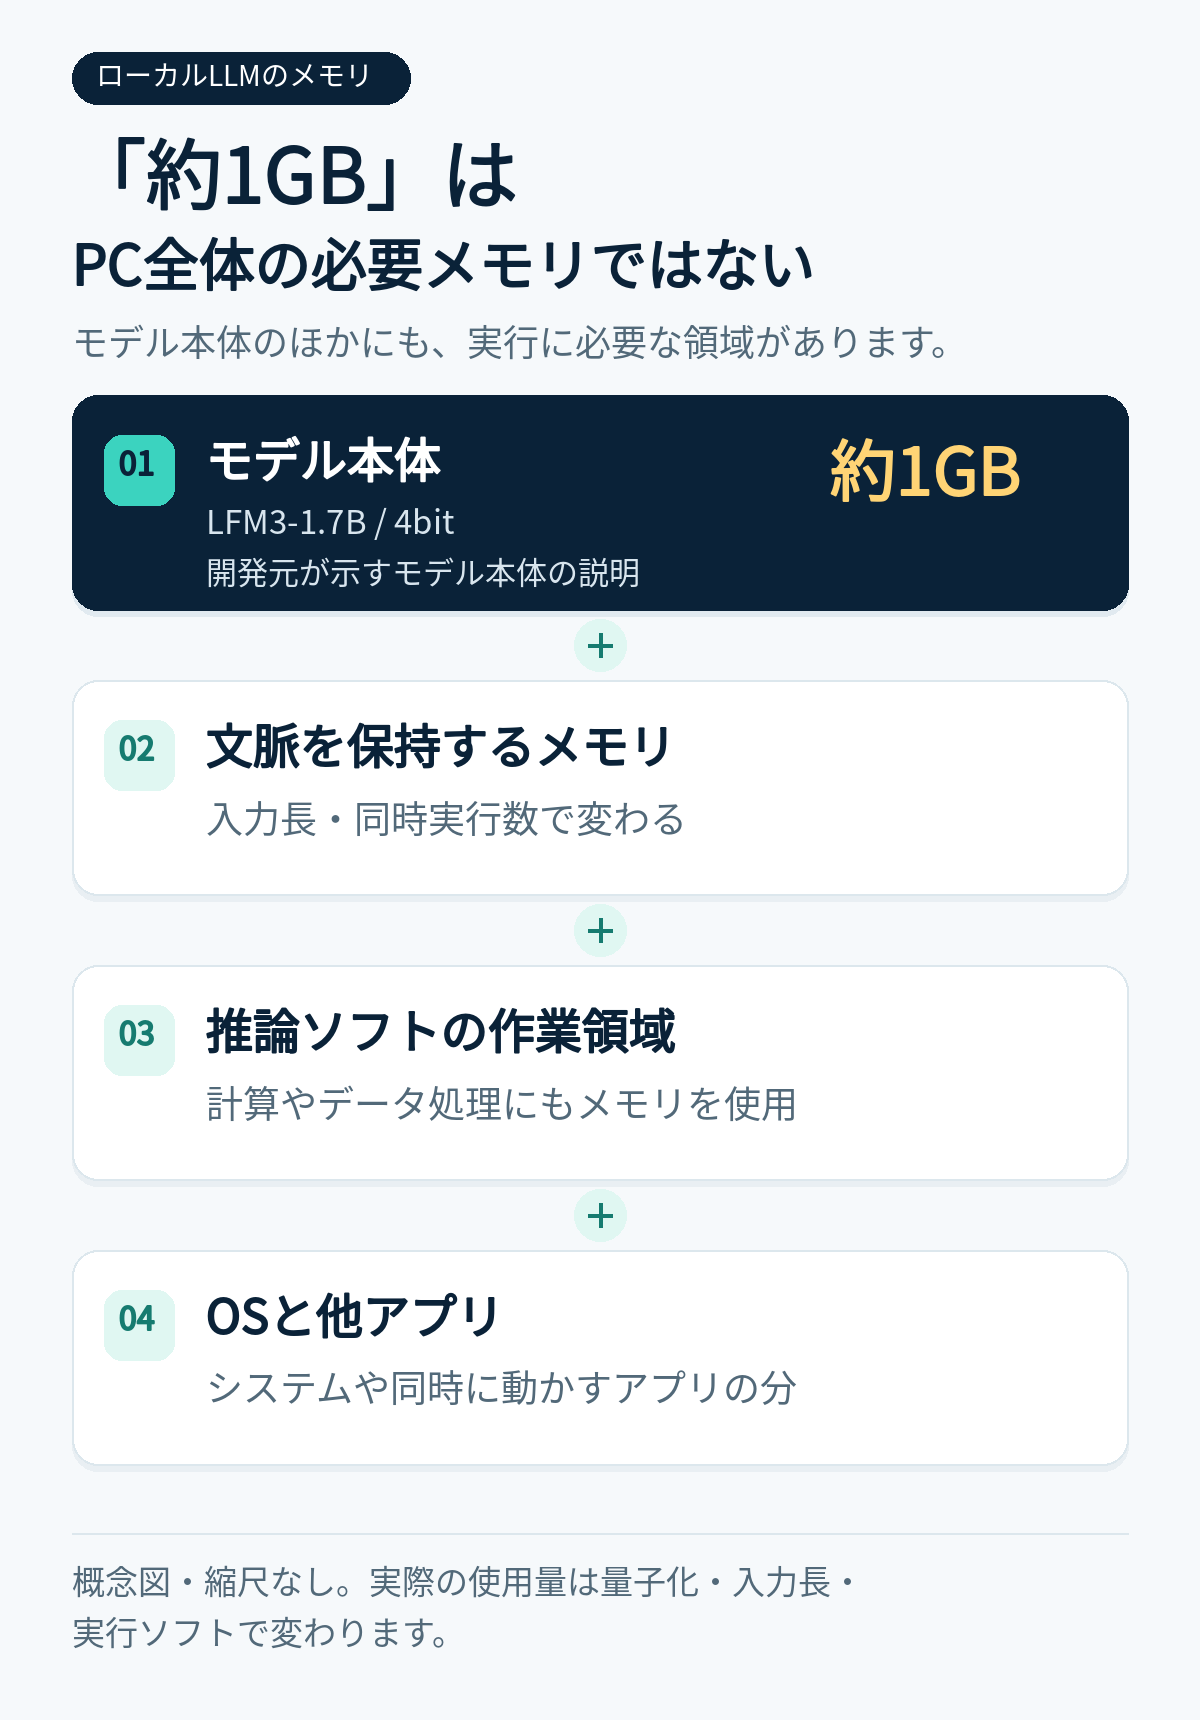
開発元は、テキストモデルのLFM3-1.7Bについて、4bit精度では約1GBに収まると説明しています。量子化とは、モデルを表現する数値の精度を落として容量を抑える方法です。小型モデルを手元で動かすうえで、このコンパクトさは魅力です。[4]
一方、実行時にはモデル本体に加えて、文脈を保持するメモリや処理用の作業領域、OS・ほかのアプリの領域も必要です。Ollamaの公式文書も、コンテキストを長くすると必要メモリが増えると説明しています。約1GBという説明を、256Kの長文を処理するときの総メモリへ置き換えてはいけません。[9]
DGX Sparkのようなマシンで試す場合も、空きメモリ、同時に動かすアプリ、実行ソフトの対応を確認したいところです。今回の記事では、Spark上でのLFM3の速度やメモリ使用量は測定していません。
まず試すなら、文章モデルから始める
Ollamaを利用している場合、公式モデルページに掲載されているテキスト版の起動コマンドは次のとおりです。LFM3に対応したバージョンを使い、初回はモデルをダウンロードできる環境で実行します。[10]
ollama run lfm3これは文章モデルの入口です。画像・音声を扱う場合は、それぞれのモデルと実行手順を選ぶ必要があります。モデルが持つ文脈上限と、実際に割り当てられた長さも別なので、最初から最大長にこだわらず、短い入力で動作を確認するのがおすすめです。[9]
試すときは、次の3項目を記録すると比較しやすくなります。
- 回答の正確さ:短い資料から指定項目を抜き出し、原文と照合する。
- 待ち時間:送信してから最初の文字が出るまでと、回答完了までを分けて測る。
- メモリの余裕:短文・長文で変化を確認し、普段使うアプリと同時に動かせるかを見る。
速さの見方については、関連記事「【DGX Spark実測】Strata vs llama.cpp|Qwen3.8-Flash-Nextの性能比較」も参考になります。こちらは別モデルの測定なので、掲載値をLFM3の性能として扱わないでください。
仕事で使う前に:得意な用途とライセンス
LFM3-1.7Bのモデルカードは、ツール呼び出しや決まった形式の出力、用途に合わせた追加学習を想定する一方、自律的なコーディングや複雑な多段推論には推奨しないとしています。大きなモデルと同じ仕事を丸ごと任せる前に、小さく切り出した作業で品質を確かめるのがよさそうです。[5]
ライセンスはLFM Open License v1.0です。重みが公開されていても、利用条件がなくなるわけではありません。原文には年商1,000万米ドルを基準とする商用利用の制限があり、主体の定義や再配布条件も定められています。企業やサービスへの組み込みでは、該当するモデルのLICENSEを確認してください。[11]
ベア三郎の見方:小型AIに任せる「一つの仕事」が面白い
今回の発表でベア三郎が面白いと感じたのは、「手元で動くAIに、どの仕事を任せるか」を考える材料が増えたことです。
たとえば、決まった書式から項目を抜き出す。短い録音を文字にする。画像について質問する。こうした用途を一つずつ試し、必要な品質と待ち時間を満たすなら、日常の道具として使い道が見えてきます。これは発表内容から考えた活用案で、個々の業務での精度を保証するものではありません。
大型モデルを載せるローカルAIも、小型モデルを身近な端末で使うローカルAIも、どちらも面白い方向です。LFM3を試すなら、まずは「自分が繰り返している、この一作業を任せられるか」から。モデル名や最大値を眺めるより、役に立つかどうかが見えてくるはずです。
よくある疑問
LFM3を入れれば、どのアプリでも音声会話できますか?
利用するモデル、実行ソフト、接続する画面やAPIの対応をそろえる必要があります。テキスト版の起動だけで音声機能まで有効になるわけではありません。
日本語の音声アシスタントとしてすぐ使えますか?
今回確認したAudio版は、日本語の音声処理と、英語のみとされる音声会話・LiveASRを区別しています。目的の機能の対応状況を確認し、実際の録音で評価する必要があります。[7]
今使っている大きなモデルから乗り換えるべき?
まずは用途を絞って比較するのがよいでしょう。文章抽出、音声処理、複雑な推論では求める能力が異なります。既存モデルを残し、正確さ・待ち時間・メモリを同じ条件で比べると判断できます。
公式情報・出典
- Liquid AI:Introducing LFM3(2026年10月27日)
- Ollama v0.40.13 リリースノート(GitHub表示:10月28日)
- llama.cpp v0.8.0 リリースノート(GitHub表示:10月28日)
- Liquid AI:Build specialized multimodal models with LFM3(2026年10月27日)
- LFM3-1.7B 公式モデルカード
- LFM3-VL-2B 公式モデルカード
- LFM3-Audio-2B 公式モデルカード
- LFM3-Omni-2B 公式モデルカード
- Ollama:Context length
- Ollama:LFM3 モデルページ
- LFM Open License v1.0 原文
掲載画像について:アイキャッチは公式ベア三郎アイコンを参照してAI生成したイメージであり、製品写真や実際の動作画面ではありません。本文のメモリ図は公式資料を踏まえたオリジナル概念図です。発表後に仕様・対応状況が変わる可能性があるため、導入時はリンク先の最新版も確認してください。
コメント