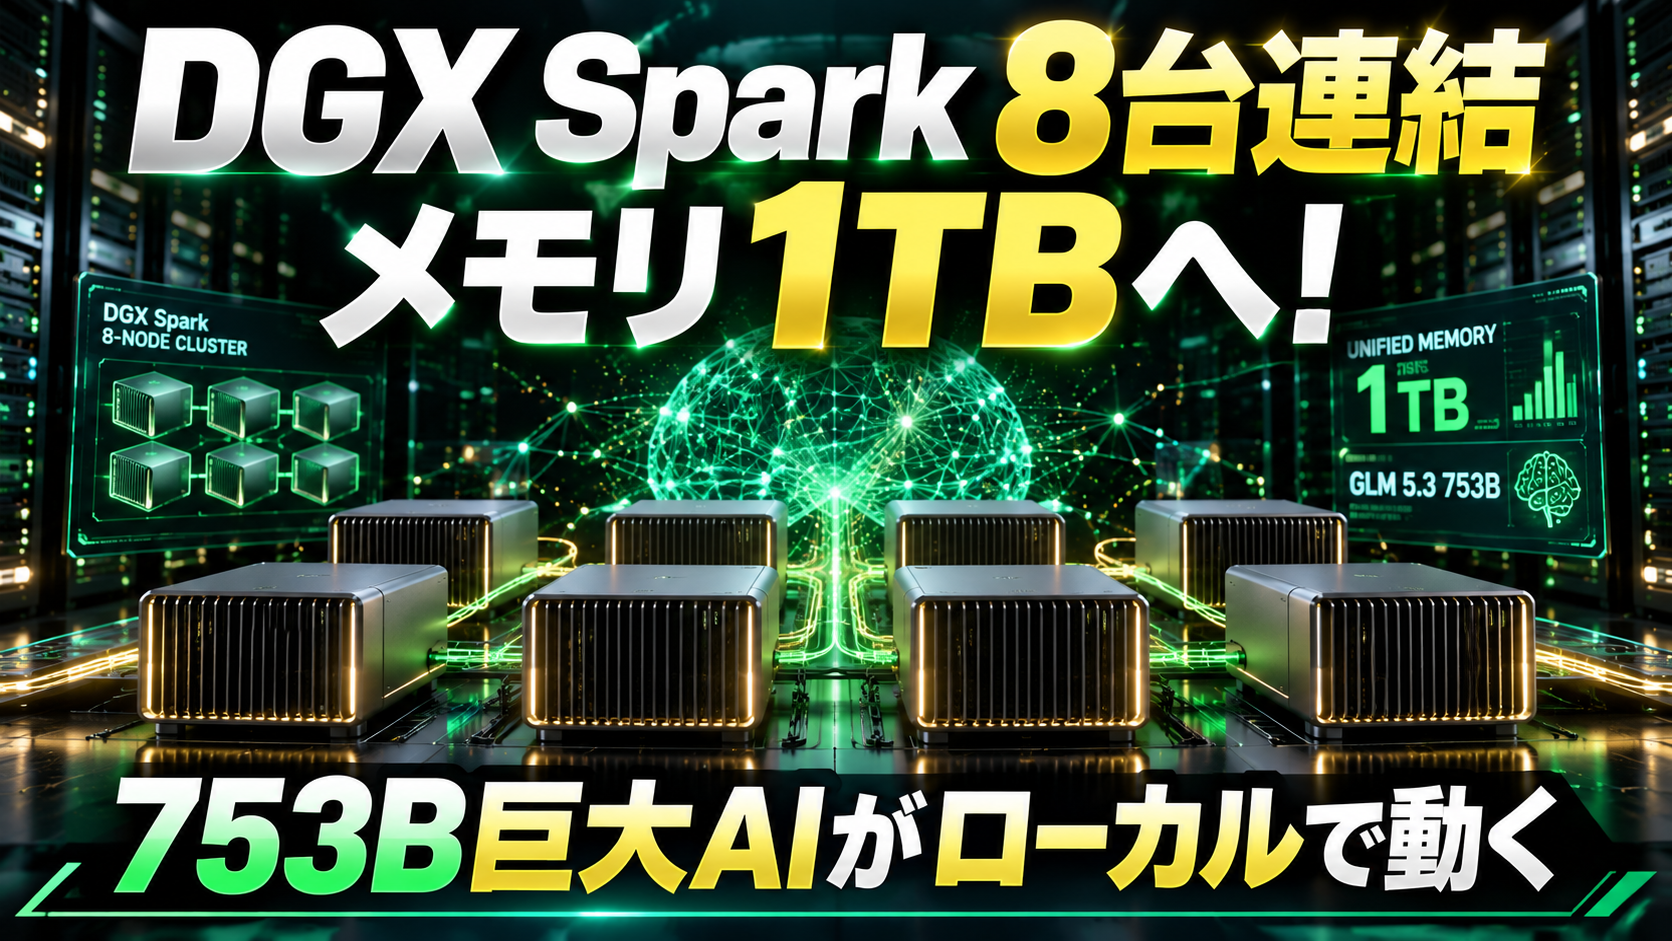
1台128GBのDGX Sparkを8台つなぐと、何ができるのか。「メモリ1TB」という派手な数字だけでなく、753Bという超巨大LLMのローカル実行、推論性能、ネットワークの組み方まで、NVIDIAが具体的な実測を公開した。
2026年10月22日、NVIDIAは公式技術ブログ「Running Frontier-Class AI Models Across 8 NVIDIA DGX Spark Nodes」で最大8台のDGX Sparkを使うクラスターを詳しく紹介。これまでの「2台接続して大きなモデルを動かす」段階から、少人数チームが複数のローカルAIを使い分ける小型AI基盤へと用途が広がっている。
今回は753Bモデルの実際の生成速度/8台で何倍速くなるのか/スイッチなしで組めるのか/今すぐ簡単に使えるのかを中心に、公式データと現実的な注意点を整理する。

まず結論:8台で1TBは事実。ただし「8倍速い」わけではない
- 合計メモリ:128GBモデルを8台使うと1,024GB(約1TB)の統合メモリ容量になる。
- 大規模モデル:GLM 5.3のフル753Bモデルを8台構成で動作させた。NVFP4モデルは約470GB。
- 生成速度:フルGLM 5.3の同時実行1では31 tokens/秒、別の「GLM 5.3 Flash」では約80 tokens/秒と報告。異なるモデルなので直接比較しない。
- 高速化:Qwen3.8-27Bの比較で、8台+スイッチ+最適化通信バックエンドなら1台比4.43倍。
- 自動構成:8台クラスターの手動構成はサポートされているが、NVIDIA Syncの8台自動構成対応は2026年末までの予定。
ここでいう「1TB」は8台のメモリを合計した規模だ。物理的に1枚のメモリになったわけではない。モデルの重みを複数GPUに分割して保持し、ネットワークでデータを交換する分散実行の仕組みが必要になる。
753BパラメータのGLM 5.3が、机の上の8台で動いた
これまでのDGX Spark記事では、2台・4台の構成で大型モデルを動かす方法や、メモリ不足による起動失敗の話題が中心だった。今回はNVIDIA自身がGLM 5.3フルモデル(753Bパラメータ)の動作結果を公開している。
NVIDIAによると、試したモデル「nvidia/GLM-5.3-NVFP4」は約470GB。8台の128GB構成で実行し、MTP3による生成高速化も利用した。注目すべきなのは、単に「モデルをロードできた」だけでなく、複数ユーザーで使う場合の生成性能まで測っている点だ。
| 同時実行数 | 合計生成速度(Decode) |
|---|---|
| 1 | 31 tokens/秒 |
| 4 | 51 tokens/秒 |
| 8 | 67 tokens/秒 |
同時実行数を増やすと総生成量は増えるが、1人あたりの速度が同じように増えるとは限らない。「全体のTPS」と「利用者が体感する速度」を分けて読む必要がある。
なお公式資料にある「約80 tokens/秒」はGLM 5.3 Flashを8台で動かした別の実験。753Bフルモデルの31 tokens/秒と混同して、「753Bが80 tokens/秒出た」と書くのは不正確だ。
8台なのに4.43倍? Qwen3.8で分かったリアルな伸び方
NVIDIAはノード数の効果を比較するため、比較的小さいQwen3.8-27B(NVFP4)を使い、投機的デコード(MTP)を無効にした条件で1〜8台を測定した。入力8,192トークン、出力256トークン、同時実行1というベンチマークだ。
| 構成 | 生成速度 | 1台比 |
|---|---|---|
| 1台 | 11.86 tokens/秒 | 1.00倍 |
| 2台・直接接続 | 21.71 tokens/秒 | 1.84倍 |
| 4台・リング | 32.82 tokens/秒 | 2.77倍 |
| 4台・スイッチ+RoCEnante | 36.34 tokens/秒 | 3.06倍 |
| 8台・リング | 40.11 tokens/秒 | 3.38倍 |
| 8台・スイッチ+RoCEnante | 52.58 tokens/秒 | 4.43倍 |
一見、「8台買って4.43倍?」と感じるかもしれない。しかしこの比較は、小さめのモデルをあえて複数台へ分割した場合の数値でもある。8台構成の最大の価値は、1台には収まらないモデルや複数モデルを扱えること。単一モデルの最高速度だけで投資効果を判断しないほうがいい。
なぜスイッチの有無で差が出る? 新技術「RoCEnante」
DGX Sparkの複数台構成では、GPU間で計算結果を交換するall-reduceなどの通信がボトルネックになりやすい。1台の中だけで完結する計算と違い、ネットワークを往復する時間が積み上がるためだ。
NVIDIAが紹介したRoCEnanteは、比較的小さなデータを少数ノード間で頻繁に交換する場面に合わせた通信バックエンド。リング状に隣へ渡していく方法ではなく、各ノードが相手へ直接データを送り、ローカルで集約する方式を採用している。
小さいメッセージのやり取りでは待ち時間を減らしやすい反面、ノード数や通信サイズが増えるほど転送データも増える。このため何でもNCCLより速いわけではない。NVIDIA自身も、NCCLがサポート上の標準であり、高並列・大規模な場合などには適すると説明している。RoCEnanteはFlashInferに統合され、起動時のテストに失敗した場合はNCCLへフォールバックする。
特に重要なのは、RoCEnanteはスイッチを使った接続が前提という点。8台のリング構成でも動作は可能だが、今回の「8台で4.43倍」という結果はスイッチ接続+RoCEnanteの条件だ。ケーブルだけをリング状につないだ構成に同じ数字を期待しないようにしたい。
2台・4台・8台、結局どの構成が現実的?
もしこれからDGX Sparkを増設するなら、台数ありきではなく用途から決めたい。
| 構成 | 向いている用途 | 注意点 |
|---|---|---|
| 1台(128GB) | 個人のローカルLLM、開発、試作 | モデル容量とKVキャッシュの余裕が制約 |
| 2台(合計256GB) | 1台に収まらないモデルを試す、分散推論の入門 | 通信・設定・障害切り分けが増える |
| 4台(合計512GB) | 大規模モデル推論、実験用の共有AI基盤 | リングかスイッチかで拡張性が異なる |
| 8台(合計1TB) | 753B級モデル、複数モデルの同時稼働、チーム利用 | ネットワーク設計・運用・コストが大きくなる |
4台までならスイッチなしの物理リングがコスト面で魅力的。一方、8台を「4台+4台」の別グループに分けたり、さまざまなモデルへ振り分けたりする場合、直接通信できるスイッチ構成が重要になる。
「1つの巨大AI」だけじゃない。複数AIを使い分けるSwitchyard
今回の発表で、将来のローカルAIサービスを考えるうえで特に興味深いのがNVIDIA NeMo Switchyardだ。
すべての質問を大きなAIモデルへ渡すと、軽い要約や簡単な質問にも高コストの推論リソースを使ってしまう。そこで簡単な処理は小型モデル、難しい処理は大型モデルに振り分ける。
NVIDIAの試作では、MiniCPM5 2Bを軽量側、Qwen3.8 Flash Nextを高性能側のモデルとして利用。対象のツール利用ベンチマークではQwenのみの構成と同等のスコアを保ちつつ、リクエストのうち大型モデルへ回す割合が25%の条件で、クラスター全体の処理量が約3倍になるとした。
これは実際の問い合わせの難易度分布や振り分け精度に依存する特定の試作構成の結果だが、考え方は非常に実用的。社内AIチャット、コーディング支援、RAG、複数人で共有する推論APIなどに展開しやすい。
学習性能は約7.79倍。ただし「753Bを学習できる」という意味ではない
NVIDIAは推論だけでなく、約8.965億パラメータのnanochatモデルをゼロから事前学習する検証も公開した。単一ノード比で、2台1.97倍、4台3.85倍、8台7.79倍。8台でのスケーリング効率は97.4%と、ほぼ線形に近い結果となった。
ただし実験したのは約9億パラメータのモデル。753Bモデルのフル学習を8台で実現した、という話ではない。大規模モデルの推論と、比較的小さいモデルの分散学習は別の検証だ。
落とし穴:「8台に増やしたら1TBのGPUになる」わけではない
ローカルAI導入で最も誤解されやすいポイントをまとめる。
- メモリは分散している:8台の合計容量が1TBになっても、アプリケーションが何もしなくても単一の1TB GPUのように扱えるわけではない。
- 通信構成で性能が変わる:RoCE、NCCL、バックエンド、リングとスイッチの違いがTPSに影響する。
- 推論は台数に比例しない:今回のQwen推論は8台で4.43倍。一方、別の小型モデルのデータ並列学習では7.79倍。仕事の内容で伸びが異なる。
- 自動設定の対応時期に注意:2026年10月28日時点で8台クラスターは手動構成に対応。NVIDIA SyncのCluster Assistantによる8台対応は年末までに提供予定であり、現時点ですべて自動で組めると断言はできない。
- 運用コストも8台分:本体の購入費だけでなく電力、設置、スイッチやケーブル、更新、監視、障害時の切り分けも考える必要がある。
すでにDGX Sparkを1台持っている人へのおすすめ
1台のDGX SparkでローカルLLMを動かしているなら、今回のニュースで慌てて7台追加する必要はない。まずは単独機の実測結果を保存することが大事だ。
見るべき指標は、単独リクエスト時の生成TPS、TTFT、コンテキストが長くなったときのメモリ使用量、複数ユーザー時のP95応答時間、モデル品質、電力消費など。複数台構成にしたら、これらと比較して何が改善し、何に追加費用がかかったかを確認する。
既存記事の【DGX Spark実測】Strata vs llama.cppは、1台を起点に推論エンジンと同時実行の差を検証している。今回の8台構成は、その先にある拡張の選択肢として見ると分かりやすい。また、4台構成でもモデルが起動しないケースも紹介しているので、メモリ容量だけで可否を判断しない点も押さえておきたい。
FAQ:8台クラスターで気になること
Q. DGX Spark 8台をスイッチなしでもつなげられる?
今回のNVIDIAのベンチマークには8台の物理リング構成が含まれる。ただし、複数の独立したグループを柔軟に扱う用途や、RoCEnanteの利用にはスイッチ構成が必要だ。
Q. 8台で753Bモデルが80 tokens/秒?
そうではない。フル753BのGLM 5.3は同時実行1で31 tokens/秒。約80 tokens/秒の報告は別の「GLM 5.3 Flash」の試験結果だ。
Q. NVIDIA Syncで8台の自動構成はもうできる?
公式発表によれば、8台は手動設定でサポートされる。NVIDIA Syncでの8台対応は2026年末までの予定。実際に導入する際は、公式Playbookと最新リリースノートの両方を確認してほしい。
Q. 1台のDGX Sparkを買ったばかり。今回のニュースで損をした?
いいえ。1台で快適に動くモデルなら、分散通信のないシンプルさはメリット。8台構成は巨大モデル・チーム共有・分散学習など別の課題を解決する選択肢だ。
まとめ:DGX Sparkは「個人向けAIマシン」から小型AIクラスターへ
最もインパクトが大きいのは、128GBの小型マシンを8台組み合わせ、合計1TBのメモリで753Bの巨大モデルを動かしたことだ。一方で、8台での4.43倍という数字は、性能が台数だけでは決まらない現実も教えてくれる。
今後注目したいのは、NVIDIA Syncの8台対応、分散推論の設定のしやすさ、Switchyardのような複数モデルの自動振り分け機能。ローカルAIの競争軸は「どのモデルが一番大きいか」だけではなく、運用しやすい形で、必要なAIを必要な人へ届けられるかへと広がりそうだ。
一次情報・参考資料
- NVIDIA公式技術ブログ:Running Frontier-Class AI Models Across 8 NVIDIA DGX Spark Nodes(2026年10月22日)
- NVIDIA公式ニュース:Bringing the Spark to Europe(2026年10月21日)
- NVIDIA公式Playbook:Serve LLMs with vLLM Across DGX Sparks
- DGX Spark公式リリースノート
※2026年10月28日時点のNVIDIA公表資料に基づく記事です。各種ベンチマークはNVIDIAによる測定であり、ベア三郎ブログが同構成を追試した結果ではありません。性能・対応時期・設定手順は変動する可能性があります。
コメント