DGX Sparkを4台そろえたら、次は高価なネットワークスイッチが必要なのか。そんな疑問に、NVIDIAがひとつの答えを出した。
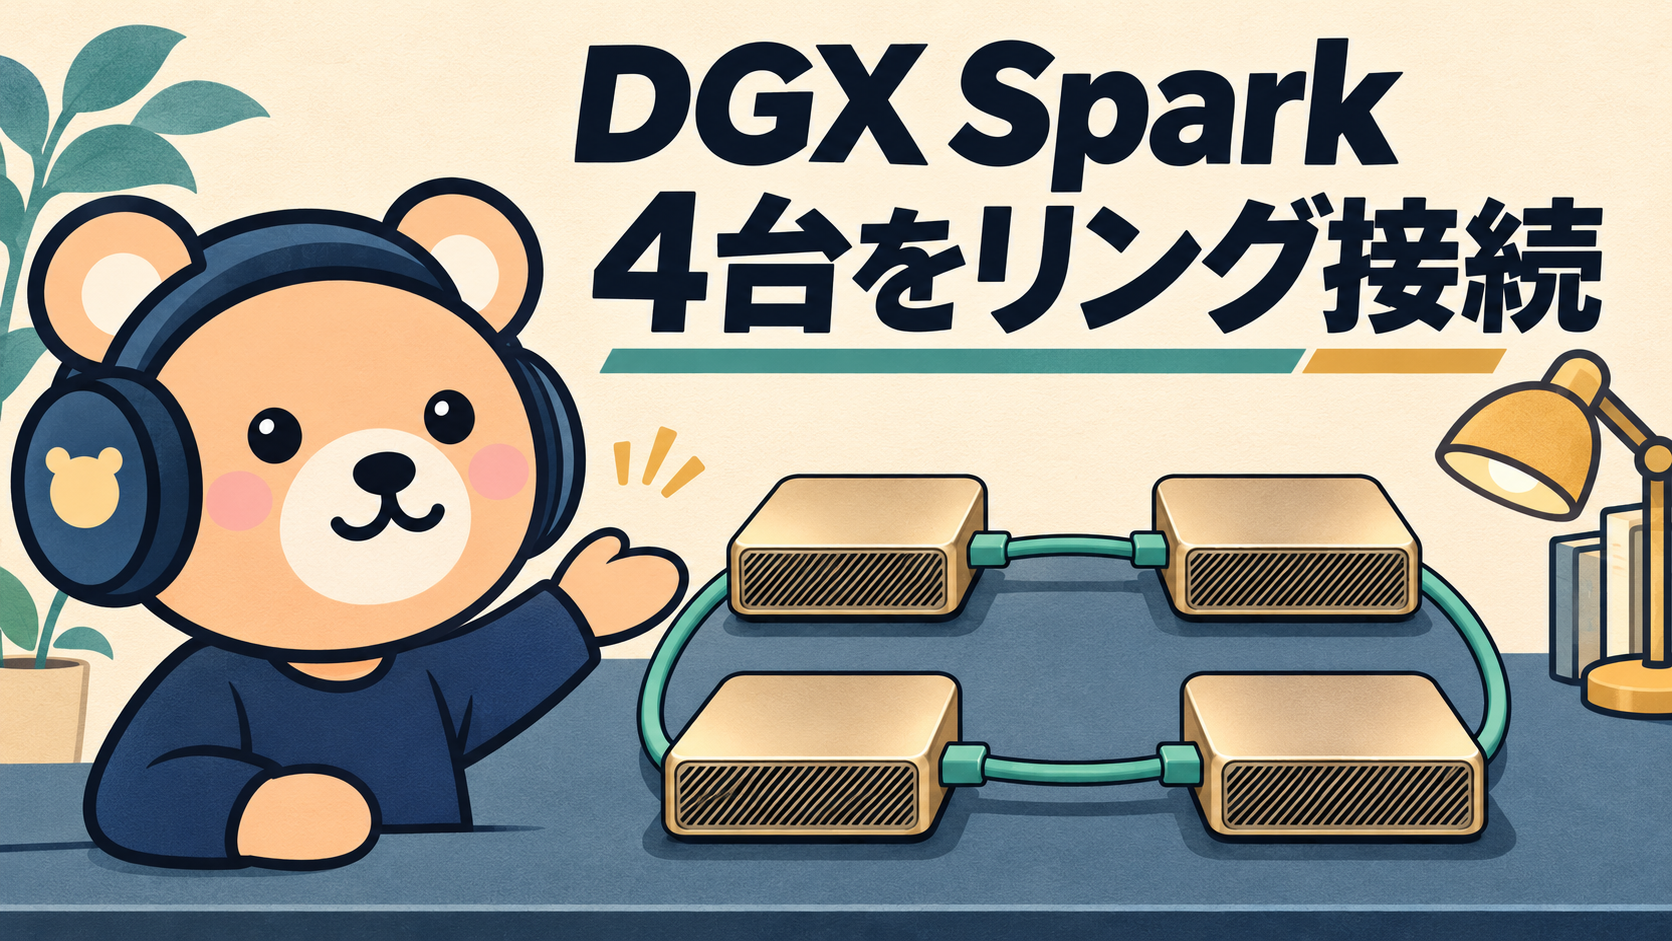
NVIDIAは2026年11月16日、シカゴで開催されたスーパーコンピューティング分野の国際会議「SC26」で、4台のDGX Sparkをリング状に接続する「DGX Spark HPC Developer Kit」を発表した。4台が隣同士で直接通信するため、専用の200GbEスイッチを用意する必要がない。
しかも、4台合計でメモリ512GB、NVMeストレージ20TB。NVIDIAは、NVFP4を使えば700B(7,000億)パラメータ級のAIモデルもローカルに展開できるとしている。小さな本体を4つ並べるだけで、これまでサーバールームの設備を想像していた規模の実験が机の上に近づいてきた。

DGX Sparkを4台つなぐと、何が変わる?
DGX Sparkは「GB10 Grace Blackwell Superchip」と128GBの統合メモリを搭載する小型AIコンピューターだ。今回のキットは、そのDGX Sparkを4台組み合わせたもの。新しい大型GPUを搭載した別製品というわけではない。
| 項目 | 4台構成の仕様 |
|---|---|
| 構成 | DGX Spark × 4台 |
| チップ | GB10 Grace Blackwell Superchip × 4 |
| メモリ | 合計512GB(各128GB) |
| ストレージ | 合計20TB NVMe(キットの公称値) |
| 接続 | ConnectX-7を使った4台リング構成 |
| 外部の200GbEスイッチ | 不要 |
| 想定モデル規模 | 最大700B級(NVFP4使用時、NVIDIA公称) |
700B級の例としてNVIDIAが挙げたのは、DeepSeek V4.1。単体のDGX Sparkでは載せにくい巨大なモデルを、複数台へ分散させて扱うのが狙いだ。
「リング接続」は、4本のケーブルで輪を作る
仕組みは意外と単純だ。各DGX Sparkの2つのQSFPポートを使い、1号機から2号機、2号機から3号機、3号機から4号機へ。最後に4号機を1号機へ戻して輪を閉じる。
| ケーブル | 接続元 | 接続先 |
|---|---|---|
| 1本目 | Spark 1:ポート0 | Spark 2:ポート1 |
| 2本目 | Spark 2:ポート0 | Spark 3:ポート1 |
| 3本目 | Spark 3:ポート0 | Spark 4:ポート1 |
| 4本目 | Spark 4:ポート0 | Spark 1:ポート1 |
これはNVIDIAの公式接続ガイドに記載された配線だ。使用するのは、NVIDIAが対応を案内しているQSFP112 DACケーブル。ケーブルの規格や長さは、購入済みのものが対応リストに入っているか確かめたい。
一点、リングは「どの2台も直接つながっている」構成ではない。例えば1号機と3号機の間には、2号機または4号機を経由する通信が生じる。配線が簡単になる代わりに、通信の流れはワークロードによって変わる。スイッチ構成と同じ性能が保証されるわけではない。
すでに4台とケーブルがあるなら、追加の機器は原則不要
既存のDGX Sparkを4台持っていて、対応するQSFP112 DACケーブルも4本あるなら、今回のリング構成のために新たなDGX Sparkや200GbEスイッチを買い直す必要はない。ここは既存ユーザーにとって大きなニュースだ。
ただし、ケーブルを差すだけで分散処理が完成するわけではない。4台を同じ管理用LANに接続し、システムソフトウェアを更新したうえで、ネットワーク設定とクラスタ構成を行う必要がある。
現行のNVIDIA公式手順では、4台リング構成は「Configure Manually」から設定する。自動セットアップのNVIDIA Syncだけで完結する構成ではない点に注意したい。公式の補助スクリプトには、実際の設定前に内容を確認する --dry-run も用意されている。
700B級AIが「載る」と「速く動く」は別の話
ここは期待しすぎないようにしたい。メモリ512GBといっても、4台それぞれが128GBを持つ構成であり、512GBの巨大な単一GPUメモリに変身するわけではない。大規模言語モデルを動かすには、モデルの重みをノード間でどう分割するか、推論時にどれほど通信が必要かが重要になる。
また、700B級という数字はNVFP4量子化を前提としたNVIDIAの公称値だ。実際のメモリ使用量はモデル構造、量子化方式、コンテキスト長、KVキャッシュなどで変わる。今回の発表資料に、700B級モデルの生成速度(TPS)や最初の応答までの時間(TTFT)を示す実測値はない。
例えば、チャット用のLLMを快適に動かしたいなら、「モデルのロードに成功した」だけでは評価しきれない。長いプロンプトを渡したときの応答開始時間や、同時接続時の速度も測ってこそ、4台構成の実力が見えてくる。
DGX Sparkを複数台使った推論には、過去にも起動やメモリ配分の難しさがあった。関連記事の「DGX Spark 4台でDeepSeekが起動しない?512GBでもハマる2つの落とし穴」も参考になる。今回の発表だけで、個別のソフトウェアの課題がすべて解消したとは考えないほうがいい。
本来の狙いはAIだけではなく、科学技術計算
「HPC Developer Kit」のHPCは、High Performance Computing(高性能計算)の略。NVIDIAが想定しているのは、巨大LLMの推論だけではない。材料シミュレーションのLAMMPSや分子動力学のNAMDなど、4台を使った科学技術計算も示している。
研究者が共有のGPUクラスタの順番を待つ代わりに、手元でコードを試し、通信処理を調整し、デバッグする。そうした開発環境として、4台をひとまとまりに使えることが価値になる。C・C++・FortranのコンパイラやMPIツールを含む「NVIDIA HPC SDK」の導入用プレイブックも公開予定だが、11月19日時点の発表では「近日公開」とされている。
本当に注目したいのは「既存の4台が公式構成になる」こと
DGX Sparkを複数台接続する試みは、今回が初めてではない。DGX Spark 8台で753B級モデルに挑んだ事例もある。今回のニュースの核心は、「4台をつなげば動くかもしれない」という実験ではなく、NVIDIA自身がスイッチ不要の4台リング構成を、公式キットと構築ガイドで前面に打ち出したことだ。
4台とケーブルをすでに用意しているなら、あとは構成を整え、実際のワークロードで測る段階に進める。巨大モデルが動くかだけでなく、どのモデルを、どの分散推論ソフトで、何人が同時に使うと効果的なのか。机上のスパコンの本当の価値は、その数字に表れるはずだ。
コメント